最大似然
在机器学习和统计学中,我们经常会遇到这样一类问题:已经拿到了一批观测数据,假设这些数据来自某个概率模型,那么模型中的参数应该取什么值,才能让这批数据的出现显得最合理?这正是 最大似然估计(Maximum Likelihood Estimation, MLE) 要解决的问题。
1.1 最大似然估计原则
假设我们已经选定了一个概率模型:p(X \mid \theta)
其中:
X=\text { 观测到的数据, } \qquad \theta=\text { 模型参数. }
最大似然估计的任务,是在已经观察到 X 的情况下,寻找一个参数 \theta,使得这批数据在模型下出现得尽可能“合理”。
数学上写成:
\hat{\theta}_{\mathrm{MLE}}=\arg \max _{\theta} p(X \mid \theta)
这里有一个非常重要的视角转换。
数据 X 已经发生了,所以优化过程中我们不再改变 X,而是不断改变模型参数 \theta,观察:p(X \mid \theta) 在什么参数处取得最大值。 因此,最大似然可以理解成:找到一个最能解释现有观测数据的模型参数。
假设一枚硬币正面朝上的概率未知,记为\theta=P(\text { 正面 }) 。那么反面出现的概率就是:P(\text { 反面 })=1-\theta
现在连续抛这枚硬币 13 次,观察到:9 次正面, 4 次反面.
问题是这枚硬币的正面概率 \theta 最可能是多少?
如果各次抛硬币相互独立,那么观察到这一具体结果的似然为:
L(\theta)=p(X \mid \theta)=\theta^{9}(1-\theta)^{4}
于是最大似然估计就是:
\hat{\theta}=\arg \max _{\theta} \theta^{9}(1-\theta)^{4}
我们暂时先不讨论怎么求最大值,单从直觉上看:
如果 \theta 很小,例如 0.1,那么出现 9 次正面显然很不合理;
如果 \theta 非常接近 1,那么出现 4 次反面又会变得很不合理;
所以最大值应该出现在某个中间位置。
最终得到: \hat{\theta}=\frac{9}{13} \approx 0.6923
也就是说,对于这组数据,MLE 会认为: \boxed{\hat{\theta} \approx 0.69}
最能解释我们观察到的结果。下图是变化\theta时,P的变化。
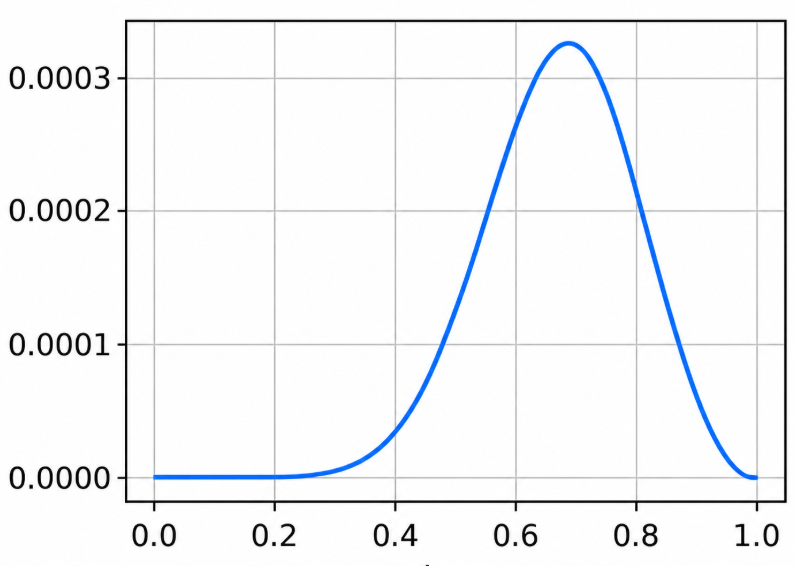
初学最大似然时,一个特别容易混淆的问题是:p(X \mid \theta)到底是概率还是似然?实际上是公式可以完全相同,但讨论对象不同。
当参数 \theta 已知,而我们研究不同数据 X 出现的可能性时,p(X \mid \theta)被看成关于 X 的概率分布。
例如已经知道一枚硬币\theta=0.7, 抛 13 次得到 9 次正面的概率是多少?这属于概率问题。
但在最大似然中,实际情况正好反过来。
数据 X 已经观察到了,我们把它固定,然后研究不同 \theta 对这批数据的解释能力:
L(\theta)=p(X \mid \theta)
此时它被称为关于 \theta 的似然函数(likelihood function)。
可以记住一句话:概率:参数固定,看数据怎么变化。似然:数据固定,看参数怎么变化。
因此似然函数虽然写作 p(X \mid \theta),但优化变量实际上是:\theta.
1.1.1 后验概率
这里还需要特别区分两个很像的表达式:p(X \mid \theta) 和 p(\theta \mid X) .
前者是似然,后者是后验概率(posterior)。
后验概率表达的是已经观察到数据 X 以后,参数 \theta 有多可信?
如果我们希望直接寻找后验概率最大的参数,那么得到的是最大后验估计(Maximum A Posteriori, MAP):
\hat{\theta}_{\mathrm{MAP}}=\arg \max _{\theta} p(\theta \mid X)
根据贝叶斯公式: p(\theta \mid X)=\frac{p(X \mid \theta)\,p(\theta)}{p(X)} .
所以: \hat{\theta}_{\mathrm{MAP}}=\arg \max _{\theta} \frac{p(X \mid \theta)\,p(\theta)}{p(X)} .
因为对于已经观察到的数据 X,p(X) 不依赖于 \theta,所以优化时可以去掉: \hat{\theta}_{\mathrm{MAP}}=\arg \max _{\theta} p(X \mid \theta)\,p(\theta) .
其中p(\theta)叫做参数的先验分布(prior)。
如果我们认为在看到数据之前,没有理由更偏好某一个参数,并在参数允许的范围内采用均匀先验 p(\theta)=\text { constant },
那么: \hat{\theta}_{\mathrm{MAP}}=\arg \max _{\theta} p(X \mid \theta)\,p(\theta)
就退化成: \hat{\theta}_{\mathrm{MLE}}=\arg \max _{\theta} p(X \mid \theta)
所以在均匀先验的情况下: \mathrm{MAP}=\mathrm{MLE}
不过需要注意一个严格的概念区别:MLE 本身并不需要先假设 p(\theta) 为常数。MLE 的定义直接就是最大化 p(X \mid \theta)
均匀先验主要用于说明为什么从 MAP 的角度看,可以退化成 MLE。
1.2 数值优化与负对数似然
把刚才的抛硬币问题推广一下。假设总共进行了:n_{H}次正面和n_{T}次反面。
似然函数为: L(\theta)=\theta^{n_{H}}(1-\theta)^{n_{T}} .
我们的目标是: \hat{\theta}=\arg \max _{\theta} L(\theta) .
稍后会看到,相比直接对这个乘积求导,通常更方便的做法是取对数: \ell(\theta)=\log L(\theta) .
于是: \ell(\theta)=n_{H} \log \theta+n_{T} \log (1-\theta) .
对 \theta 求导: \frac{d \ell}{d \theta}=\frac{n_{H}}{\theta}-\frac{n_{T}}{1-\theta} .
整理得到: n_{H}(1-\theta)=n_{T} \theta,
因此: n_{H}=\left(n_{H}+n_{T}\right) \theta .
最终: \boxed{\hat{\theta}=\frac{n_{H}}{n_{H}+n_{T}}}
这其实非常符合直觉,伯努利参数的最大似然估计,就是样本中成功的经验频率。对于前面的例子:n_{H}=9, \ n_{T}=4,因此:
\hat{\theta}=\frac{9}{13} \approx 0.6923
抛硬币看起来距离神经网络很远,但本质上,很多机器学习损失函数就是从最大似然推导出来的。
考虑二分类问题y_{i} \in\{0,1\}
假设模型对于第 i 个样本输出p_{i}=P\left(y_{i}=1 \mid x_{i}\right)
那么真实标签 y_{i} 出现的概率可以统一写成:
p\left(y_{i} \mid p_{i}\right)=p_{i}^{y_{i}}\left(1-p_{i}\right)^{1-y_{i}}
于是,对于独立样本,整个数据集的似然为: L=\prod_{i=1}^{n} p_{i}^{y_{i}}\left(1-p_{i}\right)^{1-y_{i}}
取对数: \log L=\sum_{i=1}^{n}\left[y_{i} \log p_{i}+\left(1-y_{i}\right) \log \left(1-p_{i}\right)\right]
所以最大化对数似然: \max \sum_{i}\left[y_{i} \log p_{i}+\left(1-y_{i}\right) \log \left(1-p_{i}\right)\right]
等价于最小化: -\sum_{i}\left[y_{i} \log p_{i}+\left(1-y_{i}\right) \log \left(1-p_{i}\right)\right]
这正是机器学习中非常常见的二元交叉熵损失(Binary Cross-Entropy)。
我们训练二分类模型时最小化交叉熵,从概率建模的角度看,本质上是在进行最大似然估计。
到这里可能会产生一个自然的问题。最大似然的定义明明是\max_{\theta} p(X \mid \theta),
那为什么实际机器学习中很少直接计算这个概率,而是几乎总会使用\log p(X \mid \theta)甚至-\log p(X \mid \theta) ?
主要有两个非常实际的原因:数值稳定性,以及计算与求导的便利性。
数值稳定性
假设 $ X={x_{1}, x_{2}, , x_{n}} . $
如果样本在给定参数 \theta 后条件独立,那么 p(X \mid \theta)=\prod_{i=1}^{n} p\left(x_{i} \mid \theta\right) .
这也是最大似然中最核心的结构之一: \boxed{L(\theta)=\prod_{i=1}^{n} p\left(x_{i} \mid \theta\right)}
问题在于,每一个概率通常都不大于 1。
例如假设每项都是0.5,
如果有 10^{9} 个样本,那么: L(\theta)=0.5^{10^{9}} 这个数字极端接近 0。
计算机使用有限精度的浮点数表示数字,当数值小到低于能够正常表示的范围时,可能直接被表示成:‘0 .’
这种现象就是数值下溢underflow
如果似然直接变成 0,那么继续进行比较、求导和优化都会遇到问题。
解决方法非常自然: \ell(\theta)=\log L(\theta)=\log p(X \mid \theta) .
利用 $ (a b)=a+b, $
得到: \log \prod_{i=1}^{n} p\left(x_{i} \mid \theta\right)=\sum_{i=1}^{n} \log p\left(x_{i} \mid \theta\right) .
于是: \boxed{\ell(\theta)=\sum_{i=1}^{n} \log p\left(x_{i} \mid \theta\right)}
原本大量非常小的数相乘,现在变成了一系列有限数值相加。
例如: \log \left[\left(\frac{1}{2}\right)^{10^{9}}\right]=10^{9} \log \frac{1}{2} .
使用自然对数 $ , $
因此: 10^{9} \log \frac{1}{2} \approx-6.931 \times 10^{8} .
虽然这个数绝对值很大,但它仍然是一个正常的有限数,而不是一个无限接近 0 的小数。
这使得计算过程稳定得多。
取对数不会改变最大似然结果
这依赖于对数函数的一个关键性质: $ x $ 在 $ x > 0 $ 时严格单调递增。
因此 $ L(_1) > L(_2)$
必然意味着 $ L(_1) > L(_2) $
所以最大值所在的位置不会改变 \arg\max_{\theta} L(\theta)=\arg\max_{\theta} \log L(\theta)
于是我们可以放心地把\max_{\theta} p(X\mid\theta)替换成 $ _{}p(X) $
传统优化算法通常希望“最小化损失函数”的形式。于是我们再乘一个负号:
\boxed{\mathrm{NLL}(\theta)=-\log p(X\mid\theta)}
NLL 就是Negative Log-Likelihood,即负对数似然。
于是 $ {}p(X) $, 等价于 $ {}p(X) $, 又等价于: $ _{}-p(X) $
所以在很多机器学习模型中,训练模型最小化 loss其实就是在做另一件事,最大似然估计。
对于独立样本 $=-_{i=1}^{n}p(x_i) $
实际中通常取平均负对数似然:
\boxed{ \mathrm{NLL} = -\frac{1}{n}\sum_{i=1}^{n}\log p(x_i\mid\theta) }
除以 n 不会改变最优参数的位置,只是改变了损失函数的整体尺度。
再来看抛硬币。 $ L()={n_H}(1-){n_T} $
再取负对数 $ ()=-$
得到:
\boxed{ \mathrm{NLL}(\theta) = -n_H\log\theta-n_T\log(1-\theta) }
这就是二元交叉熵。
对于 n 个样本:
\theta^* = \frac{\sum_{i=1}^{n}y_i}{n} = \frac{n_H}{n_T+n_H}
在神经网络中,参数数量可能达到百万甚至数十亿,一般不可能像伯努利分布这样直接推导出解析解,于是实际训练通常使用数值优化,例如梯度下降及其各种变体,不断更新参数。
求导更简单
除了防止数值下溢,对数还有另外一个重要作用,把乘积变成求和。
假设:
L(\theta)=p(x_1\mid\theta)p(x_2\mid\theta)\cdots p(x_n\mid\theta).
如果直接求导,需要使用乘积求导法则:
\frac{dL}{d\theta} = \frac{\partial p(x_1\mid\theta)}{\partial\theta} p(x_2\mid\theta)\cdots p(x_n\mid\theta)
+p(x_1\mid\theta) \frac{\partial p(x_2\mid\theta)}{\partial\theta} \cdots p(x_n\mid\theta)+\cdots.
一共有 n 项,每一项又包含许多乘法。
如果按这种最朴素的形式直接计算,计算量会非常大,可粗略达到:
O(n^2).
而取对数以后:
-\log L(\theta) = -\sum_{i=1}^{n}\log p(x_i\mid\theta),
求导得到:
-\frac{d}{d\theta}\log L(\theta) = -\sum_{i=1}^{n} \frac{1}{p(x_i\mid\theta)} \frac{\partial p(x_i\mid\theta)}{\partial\theta}.
从形式上看,复杂的“大乘积”变成了简单的“逐项求和”,一次遍历即可计算,结构通常为:
O(n).
在现代自动微分系统中,并不会真的按照最原始的 O(n^2) 形式实现整个乘积导数,但“乘法变加法、计算图更稳定、更易优化”这个核心思想依然非常重要。
1.3 从负对数似然走向信息论
负对数 $ -p $ 除了是一种损失函数,还有一个非常直观的信息论意义。
假设一个事件发生的概率是: $ p_i. $ 它发生时带来的信息量可以定义为: $ I_i=-p_i $ 这个定义有一个非常符合直觉的性质:
如果事件概率很大: $ p_i, $
那么 $ -p_i. $ 因为不怎么稀奇的事件没有信息。
比如太阳明天还会升起是一个高概率事件,因此它发生时并不会令人意外。
反过来,如果: $ p_i, $
那么 $ -p_i $ 就很大。
也就是说,越低概率的事件一旦发生,带来的信息量越大,也越令人惊讶。
如果一个离散随机变量可能产生若干种结果,第 i 种结果发生的概率为 p_i,那么随机变量的平均信息量称为熵(Entropy):
H(p)=-\sum_i p_i\log p_i
其中 $ -p_i $ 是第 i 个事件真正发生时带来的信息量;
而 $ p_i $ 表示这个事件的社会频率。
因此 $ H(p) $ 可以理解为 按照真实概率对每一种事件的信息量求平均。
这就是为什么熵常被解释成一个概率分布的“平均不确定性”。
我们假设实际问题分布 $ p(x), $ 而模型预测出来的分布为 $ q_(x). $
我们想用模型 q_\theta 去描述真实数据 p 时,对应的平均编码代价称为交叉熵(Cross-Entropy):
H(p,q_\theta) = -\sum_x p(x)\log q_\theta(x)
它有两个分布,即 $ p=, $ 与 $ q_=. $
我们无法直接改变真实世界的 p,但可以通过调整参数 \theta 来改变 $ q_. $
因此训练的目标就是让模型预测的分布越来越接近真实数据分布。
考虑一个 K 分类问题。 标签使用 one-hot 编码: $ (y_1,y_2,,y_K). $
模型输出的预测概率为 $ (p_1,p_2,,p_K). $
交叉熵损失为:
L=-\sum_{k=1}^{K}y_k\log\hat p_k
由于 one-hot 标签只有真实类别的位置为 1,其余位置全部为 0,因此实际上:
$ L=-p_c. $
其中 $ c $ 是真实类别在标签向量中的索引。
因此 $ -p_c $ 就是这个样本的负对数似然。
所以分类问题中常见的 Cross-Entropy Loss. 从概率建模角度看,本质就是: Negative Log-Likelihood
1.4 连续随机变量的最大似然
到现在,我们讨论的似然函数,全部都基于概率质量函数。
对于离散随机变量,可以直接写成 $ P(X=x_i). $
但连续随机变量有一个重要性质,即 $ P(X=x_i)=0 $ ,那么问题来了。
最大似然不是在计算: $ p(x_i) $ 吗?
既然连续变量单个精确点的概率永远为 0,最大似然岂不是没有意义?
关键在于连续随机变量里我们实际使用的 p(x_i\mid\theta),严格来说代表的是概率密度值,而不是单点概率。
考虑一个连续随机变量 X。虽然: $ P(X=x_i)=0, $
但是一个很小区间,如 $ [x_i,x_i+] $ 的概率并不为 0。
它等于:
P(X\in[x_i,x_i+\epsilon]\mid\theta) = \int_{x_i}^{x_i+\epsilon}p(x\mid\theta)\,dx.
如果 $ $ 非常小,那么在这个很窄区间中,概率密度几乎不会发生明显变化,因此 $ p(x)p(x_i). $
于是:
P(X\in[x_i,x_i+\epsilon]\mid\theta) \approx p(x_i\mid\theta)\epsilon.
\boxed{ P(\text{落在 }x_i\text{ 附近}) \approx \text{区间宽度}\times\text{该处概率密度} }
这正是概率密度的几何意义。
假设观测到 $ x_1,x_2,,x_N. $
不是直接讨论 $ P(X_1=x_1,,X_N=x_N), $ 因为这个概率都为 0。
相反,考虑每一个观测值都落在一个很小的区间 $ [x_i,x_i+]. $
如果样本条件独立,那么这些事件同时发生的概率大约为:
P \approx p(x_1\mid\theta)p(x_2\mid\theta)\cdots p(x_N\mid\theta)\epsilon^N.
因此 $ P N_{i=1}{N}p(x_i). $
取对数:
-\log P = -N\log\epsilon - \sum_{i=1}^{N}\log p(x_i\mid\theta).
现在注意 $ -N $ 和参数 $ $ 没有任何关系。
因此在寻找最优参数时,这个常数项完全可以去掉:
\arg\min_{\theta}[-\log P] = \arg\min_{\theta} \left[ -\sum_{i=1}^{N}\log p(x_i\mid\theta) \right].
于是最终又回到了熟悉的最大似然形式:
\boxed{ \hat{\theta} = \arg\max_{\theta} \prod_{i=1}^{N}p(x_i\mid\theta) }
或者等价地:
\boxed{ \hat{\theta} = \arg\min_{\theta} \left[ -\sum_{i=1}^{N}\log p(x_i\mid\theta) \right] }
这里的:
p(x_i\mid\theta)
是概率密度函数在 x_i 处的值。
所以连续变量最大似然并不是在计算:
P(X=x_i)=p(x_i\mid\theta).
而是用概率密度,衡量最不同参数下,哪些数据出现概率密度更高。
1.5 小结
现在我们将这篇文章的思路串通起来.
首先,似然认为数据来自某个参数化的概率模型 $ p(X). $ 我们的模型实际输出概率或密度的参数,因此通常定义: $ =_{}p(X). $
假设所有样本独立同分布,则有:
p(X\mid\theta)=\prod_i p(x_i\mid\theta).
为了避免大量小概率相乘造成的数值下溢,同时让乘法变成求和,通常会取对数:
\arg\max_{\theta}\sum_i\log p(x_i\mid\theta).
为了符合机器学习中最小化 loss的习惯,再乘上负号:
\min_{\theta}-\sum_i\log p(x_i\mid\theta).
于是得到了负对数似然。
如果模型是伯努利分布,就会得到二元交叉熵;如果模型是多类别的分类分布,就会得到多分类交叉熵。
再从信息论角度看, $ -p $ 又代表这个事件发生时的信息量。 因此,如果模型认为真实发生的事情几乎不可能, $ p, $ ,可以得到 $ -p+, $, 即损失很大。
如果模型认为真实类别概率接近 1, 那么 $ -p, $ , 即损失很小。
这就解释为什么交叉熵会强烈惩罚非常自信但预测错误的模型。
从预测上看,最大似然、负对数似然、交叉熵,都可以看成学习中的 loss 像是一棵不同的概念,它们其实在同一条概率建模的主线上:
- MLE:选择最能解释数据的参数 \theta,即 \arg\max_{\theta}p(X\mid\theta)。
- MAP:最大化后验 p(\theta\mid X),加入了先验 p(\theta),在充分数据下与 MLE 一致。
- 独立样本:联合似然可以写成\prod_i p(x_i\mid\theta)。
- 对数似然:利用对数把乘积变成求和,同时也能避免数值下溢和梯度数值不稳定。
- NLL:最大化 log-likelihood 等价于最小化 negative log-likelihood。
- 分类问题:每得到一个样本的类别 y,NLL 就等于对应的交叉熵损失。
- 信息论:-\log p 是事件的信息量,且 p\to1 时趋近 0,概率越小信息量越大;交叉熵衡量真实分布 p 用模型分布 q 表示时的平均代价。
- 连续变量:单点概率都为 0,但分区间概率约等于 p(x_i\mid\theta)\cdot\delta;去掉与参数无关的 \delta^N,仍然得到概率密度乘积形式的最大似然。
最终,我们训练中常常使用的目标函数:
\boxed{ \mathcal{L}(\theta) = -\frac{1}{N}\sum_{i=1}^{N}\log p(x_i\mid\theta) }
并不是一个凭空设计出来的让计算好优化的损失函数。
它背后的主线非常清晰,即让模型尽可能认为:我们真正观察到的数据,是很可能发生的。
这就是最大似然估计最核心的思想。