前置知识点:
对于离散随机变量 X ,我们通常使用概率质量函数 PMF: $ P(X = x). $
例如掷骰子:
P(X=3)=\frac{1}{6}.
对于连续随机变量,单独一个点的概率通常为 0 ,因此不能再通过 P(X=x) 描述它,而使用概率密度函数 PDF: $ f_X(x). $
概率需要通过积分获得:
P(a \leq X \leq b)=\int_a^b f_X(x)\,dx.
无论离散还是连续随机变量,都可以定义累积分布函数 CDF:
F_X(x)=P(X\leq x).
离散分布的 CDF 往往呈”阶梯状”,连续分布的 CDF 则通常是一条连续曲线。
1.1 Bernoulli 分布
1.1.1 Bernoulli 分布
设一次随机实验只有两种可能:
成功概率为 p ,失败概率自然是 $ 1-p. $
于是
X \sim \mathrm{Bernoulli}(p), \qquad 0 \leq p \leq 1.
概率质量函数写成:
P(X = x) = p^x (1-p)^{1-x}, \qquad x \in \{0,1\}.
一个公式可以同时描述两种结果。
1.1.2 Bernoulli 的均值和方差
因为 X 只能取 0 或 1,故其均值为:
E[X] = 0(1-p) + 1p = p.
再注意到 $ X^2 = X $ 所以:
E[X^2] = p.
于是
\mathrm{Var}(X) = E[X^2] - E[X]^2 = p - p^2,
即
\boxed{\sigma_X^2 = p(1-p)}.
1.1.3 Bernoulli 的 CDF
CDF 定义为 $ F(x) = P(X x). $
因此:
F(x) =
\begin{cases}
0, & x < 0, \\
1-p, & 0 \leq x < 1, \\
1, & x \geq 1.
\end{cases}
这是典型的阶梯函数。
1.1.4 用均匀随机数构造 Bernoulli 样本
一个非常重要的思想是:
如果 $ U U(0,1), $
定义
X = \mathbf{1}(U < p),
也就是:
X =
\begin{cases}
1, & U < p, \\
0, & U \geq p,
\end{cases}
那么
P(X=1) = P(U < p) = p,
所以
X \sim \mathrm{Bernoulli}(p).
这也是计算机生成 Bernoulli 随机变量最直接的思想之一。
代码
import torch= 0.3 # torch.rand(10, 10)会生成10 × 10 大小的,在[0, 1]之间的均匀随机数 # 然后逐元素进行判断,变为布尔型变量,最后使用.float()变为浮点数,这样就只有0或1了. = (torch.rand(10 , 10 ) < p).float ()print (samples)
tensor([[0., 0., 0., 0., 0., 1., 0., 1., 0., 0.],
        [0., 0., 1., 1., 0., 0., 0., 1., 0., 0.],
        [0., 0., 0., 1., 0., 1., 0., 1., 1., 0.],
        [0., 0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [1., 0., 1., 1., 0., 0., 0., 0., 1., 0.],
        [0., 1., 1., 0., 1., 0., 0., 1., 1., 1.],
        [0., 0., 1., 0., 0., 0., 0., 0., 0., 0.],
        [0., 0., 0., 1., 1., 0., 0., 0., 0., 0.],
        [0., 1., 0., 1., 0., 0., 0., 1., 0., 0.],
        [0., 1., 0., 0., 1., 0., 0., 0., 0., 0.]])
代码
# PyTorch 也直接提供了Bernoulli分布 = torch.full((10 , 10 ), 0.3 ) # 生成一个全是0.3的矩阵 = torch.bernoulli(probs) # 对应每个元素取1的概率为probs中对应的元素值,故都为0.3 print (samples)
tensor([[1., 0., 1., 0., 1., 1., 0., 1., 0., 0.],
        [0., 0., 1., 0., 0., 1., 1., 0., 0., 1.],
        [1., 1., 0., 0., 0., 0., 0., 0., 1., 0.],
        [0., 0., 0., 1., 1., 0., 0., 0., 0., 0.],
        [0., 1., 0., 0., 0., 0., 0., 0., 1., 1.],
        [0., 0., 1., 0., 0., 0., 0., 0., 0., 1.],
        [0., 0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [1., 0., 0., 1., 1., 0., 0., 1., 1., 1.],
        [0., 0., 0., 0., 1., 0., 1., 1., 0., 0.],
        [0., 1., 0., 1., 0., 0., 0., 1., 0., 0.]])
1.4.3 代码实现
这是随机数生成中非常实用的变换。
若 $ U U(0,1), $
令 $ X = a + (b-a)U, $
则 $ X U(a,b). $
代码
= 2 = 8 = (b - a) * torch.rand(10 ) + a
tensor([7.5003, 2.5937, 6.1088, 2.2114, 2.4510, 5.9701, 3.5091, 3.6569, 3.9466,
        3.9394])
这个思想之后还能推广到更一般的逆变换采样 。
1.5 Binomial 分布
现在从一次 Bernoulli 试验扩展到多次。
假设独立进行 n 次 Bernoulli 试验:
X_i \sim \mathrm{Bernoulli}(p), \qquad i = 1,\ldots,n.
定义:
X = X_1 + X_2 + \cdots + X_n.
因为每一个 X_i 只有 0 或 1,所以 X 就表示n 次试验中一共成功了多少次。
于是
\boxed{X \sim \mathrm{Binomial}(n,p)}.
如果恰好成功 k 次,某一个固定成功排列的概率是 $ p^k (1-p)^{n-k}. $
但是哪 k 次成功可以有很多种排列。
一共有 $ C = $ 种选法。
因此:
\boxed{P(X=k) = C\binom{n}{k} p^k (1-p)^{n-k}}
其中 $ k = 0, 1, , n. $
1.5.1 均值和方差
由于 $ X = _{i=1}^{n} X_i, $
利用期望的线性性 $ E[X] = _{i=1}^{n} E[X_i] = np. $
所以 $ E[X] = np $
由于独立:
\mathrm{Var}(X) = \sum_{i=1}^{n} \mathrm{Var}(X_i) = np(1-p).
因此:
\boxed{\mathrm{Var}(X) = np(1-p)}.
这也很好记:
\mathrm{Bernoulli}(p) \quad \longrightarrow \quad \mathrm{Binomial}(n,p)
时,均值和方差都相当于放大 n 倍。
1.5.2 CDF
对于整数 k ,有: $ P(X k) = _{i=0}^{k} p^i (1-p)^{n-i}. $
严格写成任意实数 x 时:
F(x) =
\begin{cases}
0, & x < 0, \\
\displaystyle\sum_{i=0}^{\lfloor x \rfloor} \binom{n}{i} p^i (1-p)^{n-i}, & 0 \leq x < n, \\
1, & x \geq n.
\end{cases}
1.6 Poisson 分布
Poisson 分布最常用于计数问题 。
例如:
一分钟内来了多少辆车;
一小时收到多少通电话;
某一区域内发生多少次缺陷;
某时间区间收到多少个请求;
固定长度 DNA 序列出现多少个特定突变。
核心问题是在固定时间或空间范围内,某类随机事件出现了多少次?
记 $ X (), $ 其中 $ > 0. $
X 的取值为 $ 0, 1, 2, $
Poisson 分布的概率质量函数:
\boxed{P(X=k) = \frac{\lambda^k e^{-\lambda}}{k!}}, \qquad k = 0, 1, 2, \ldots
1.6.1 \lambda 的含义
\lambda 可以理解成给定观察区间中的平均事件次数。
例如某事件平均每 5 分钟发生一次,那么在 1 分钟内的平均发生次数为 $ = = 0.2. $
因此一分钟内事件数可以建模为:
X \sim \mathrm{Poisson}(0.2),
前提当然是问题基本满足 Poisson 模型的假设。
Poisson 分布满足 $ E[X] = $
并且 $ (X) = $
也就是说:
\mu_X = \sigma_X^2 = \lambda.
均值与方差相同是 Poisson 分布的标志性性质之一。
1.6.2 CDF
Poisson 的 CDF 没有像均匀分布那样特别简单的初等表达式。
对于整数 k \geq 0 :
F(k) = P(X \leq k) = e^{-\lambda} \sum_{m=0}^{k} \frac{\lambda^m}{m!}.
对一般实数 x \geq 0 :
F(x) = e^{-\lambda} \sum_{m=0}^{\lfloor x \rfloor} \frac{\lambda^m}{m!}.
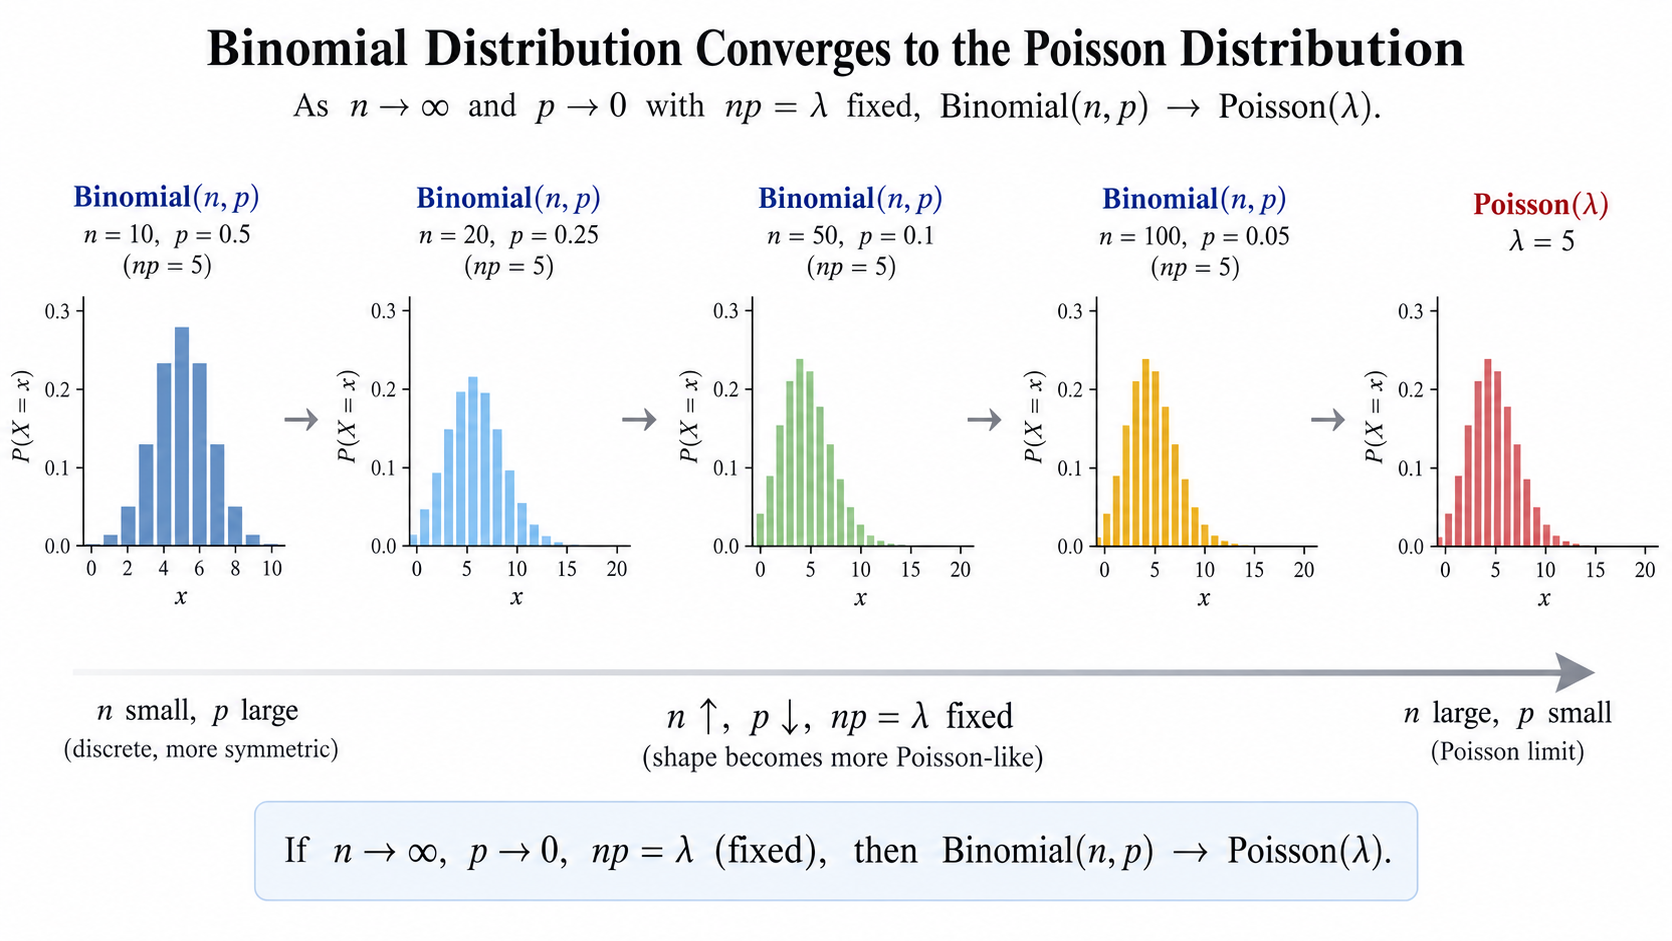
1.6.3 为什么 Binomial 会趋近 Poisson?
假设 $ X_n (n, p_n). $
如果试验次数越来越大,即 $ n , $
同时每一次成功概率越来越小 $ p_n , $
但保持 $ n p_n = $ 不变,那么:
\boxed{X_n \xrightarrow{d} \mathrm{Poisson}(\lambda)}.
最常写成:
p_n = \frac{\lambda}{n}.
于是:
X_n \sim \mathrm{Binomial}\left(n, \frac{\lambda}{n}\right).
Binomial PMF 为:
P(X_n = k) = \binom{n}{k} \left(\frac{\lambda}{n}\right)^k \left(1 - \frac{\lambda}{n}\right)^{n-k}.
当 n \to \infty 时:
\left(1 - \frac{\lambda}{n}\right)^n \to e^{-\lambda}.
同时对于固定 k :
\binom{n}{k} \left(\frac{1}{n}\right)^k \to \frac{1}{k!}.
因此:
P(X_n = k) \to \frac{\lambda^k e^{-\lambda}}{k!}.
右边正是 Poisson PMF。
所以:
\boxed{\mathrm{Binomial}\left(n, \frac{\lambda}{n}\right) \to \mathrm{Poisson}(\lambda)}.
我们举一个具体的数值例子:
假如 $ n = 10000, p = 0.001. $
那么 $ np = 10. $
于是 $ (10000, 0.001) $ 往往可以用 $ (10) $ 进行近似。
其直觉是,有非常多次机会,但每次事件发生的概率极小,于是我们关心固定区间中的稀有事件计数 。
1.7 Gaussian / Normal 正态分布
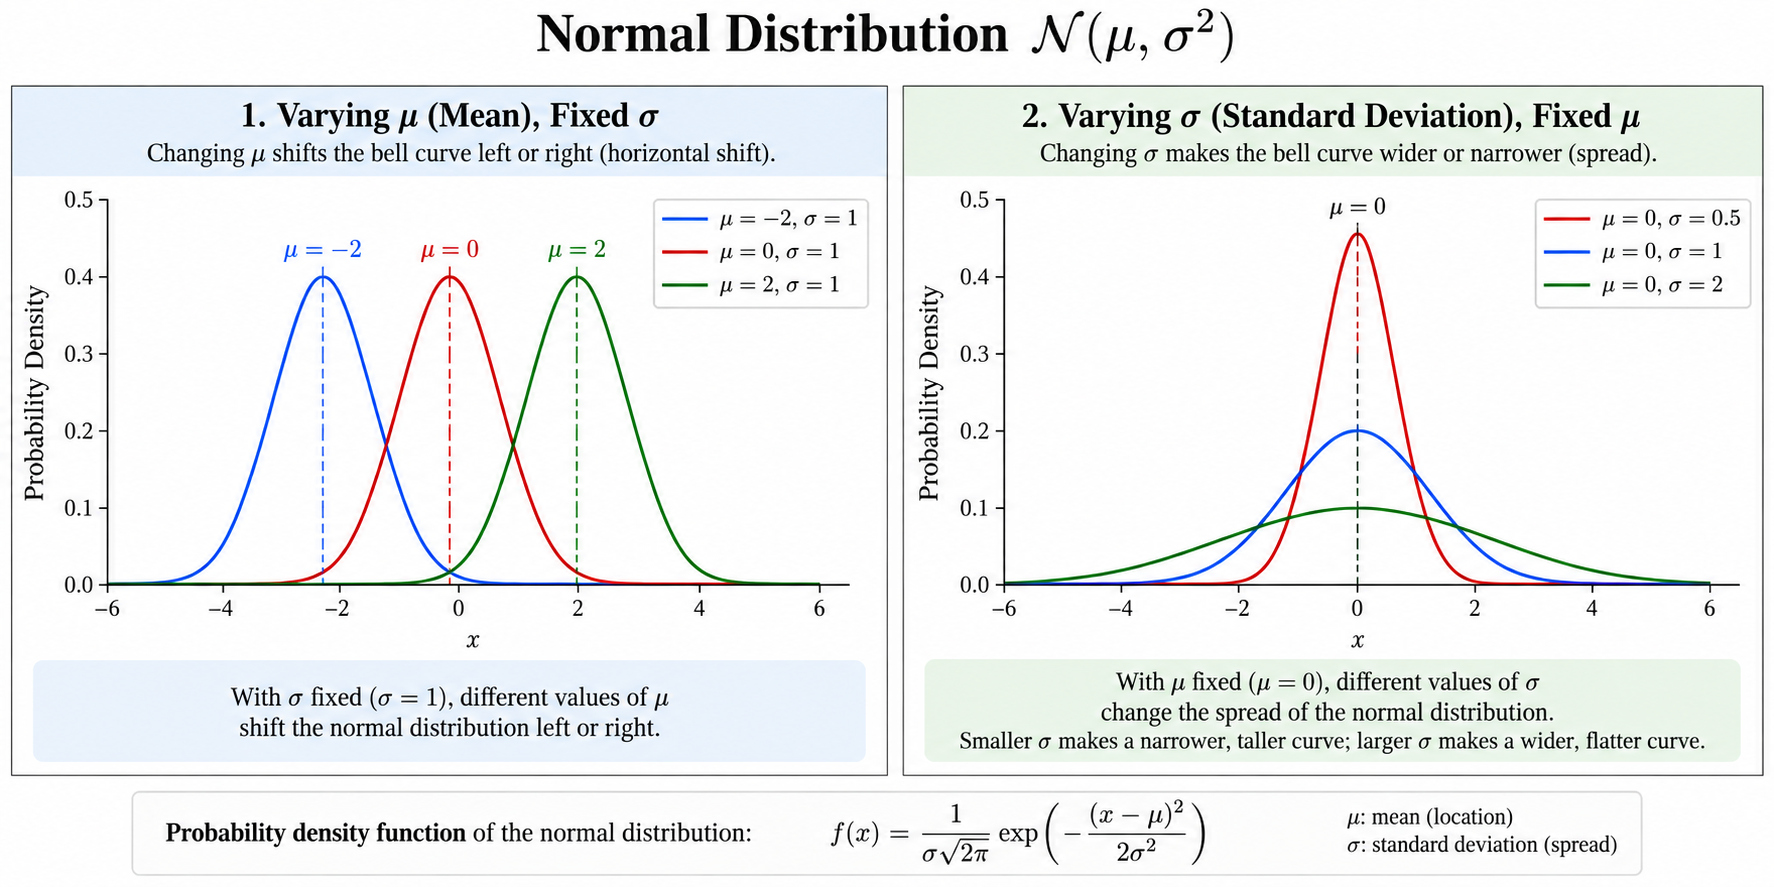
另一个几乎无处不在的分布是 Gaussian,也叫 Normal Distribution,中文通常称为高斯分布 / 正态分布 。
记 $ X (, ^2). $
其中:
\mu :均值;\sigma^2 :方差;\sigma :标准差。
它的概率密度是 $ p(x) = (-) $
其中两个参数的影响范围为:
\mu :控制中心位置
$ $决定钟形曲线向左还是向右移动。
\sigma :控制宽窄
\sigma 越大,曲线越宽;峰越低;数据越分散。越小则相反
1.7.1 中心极限定理
高斯分布的重要性并不只是因为它长得漂亮。
真正关键的是中心极限定理 Central Limit Theorem, CLT。
假设 $ X_1, X_2, , X_n $ 是一组独立同分布随机变量,并且: $ E[X_i] = , (X_i) = ^2 < . $
定义样本均值:
\bar{X}_n = \frac{1}{n}\sum_{i=1}^{n} X_i.
则:
E[\bar{X}_n] = \mu,
并且:
\mathrm{Var}(\bar{X}_n) = \frac{\sigma^2}{n}.
进行标准化:
Z_n = \frac{\bar{X}_n - \mu}{\sigma/\sqrt{n}}.
当
n \to \infty
时:
\boxed{Z_n \xrightarrow{d} \mathcal{N}(0,1)}.
等价地,也经常写成和的形式:
\boxed{\frac{\sum_{i=1}^{n} X_i - n\mu}{\sigma\sqrt{n}} \xrightarrow{d} \mathcal{N}(0,1)}.
中心极限定理最令人惊讶的地方在于,原始随机变量本身不一定是 Gaussian。只要满足相应条件,大量独立随机影响相加之后,其标准化结果都会越来越接近正态分布。
例如原始随机变量甚至可以是 $ X_i (p). $
由于 $ X_1 + + X_n (n,p), $
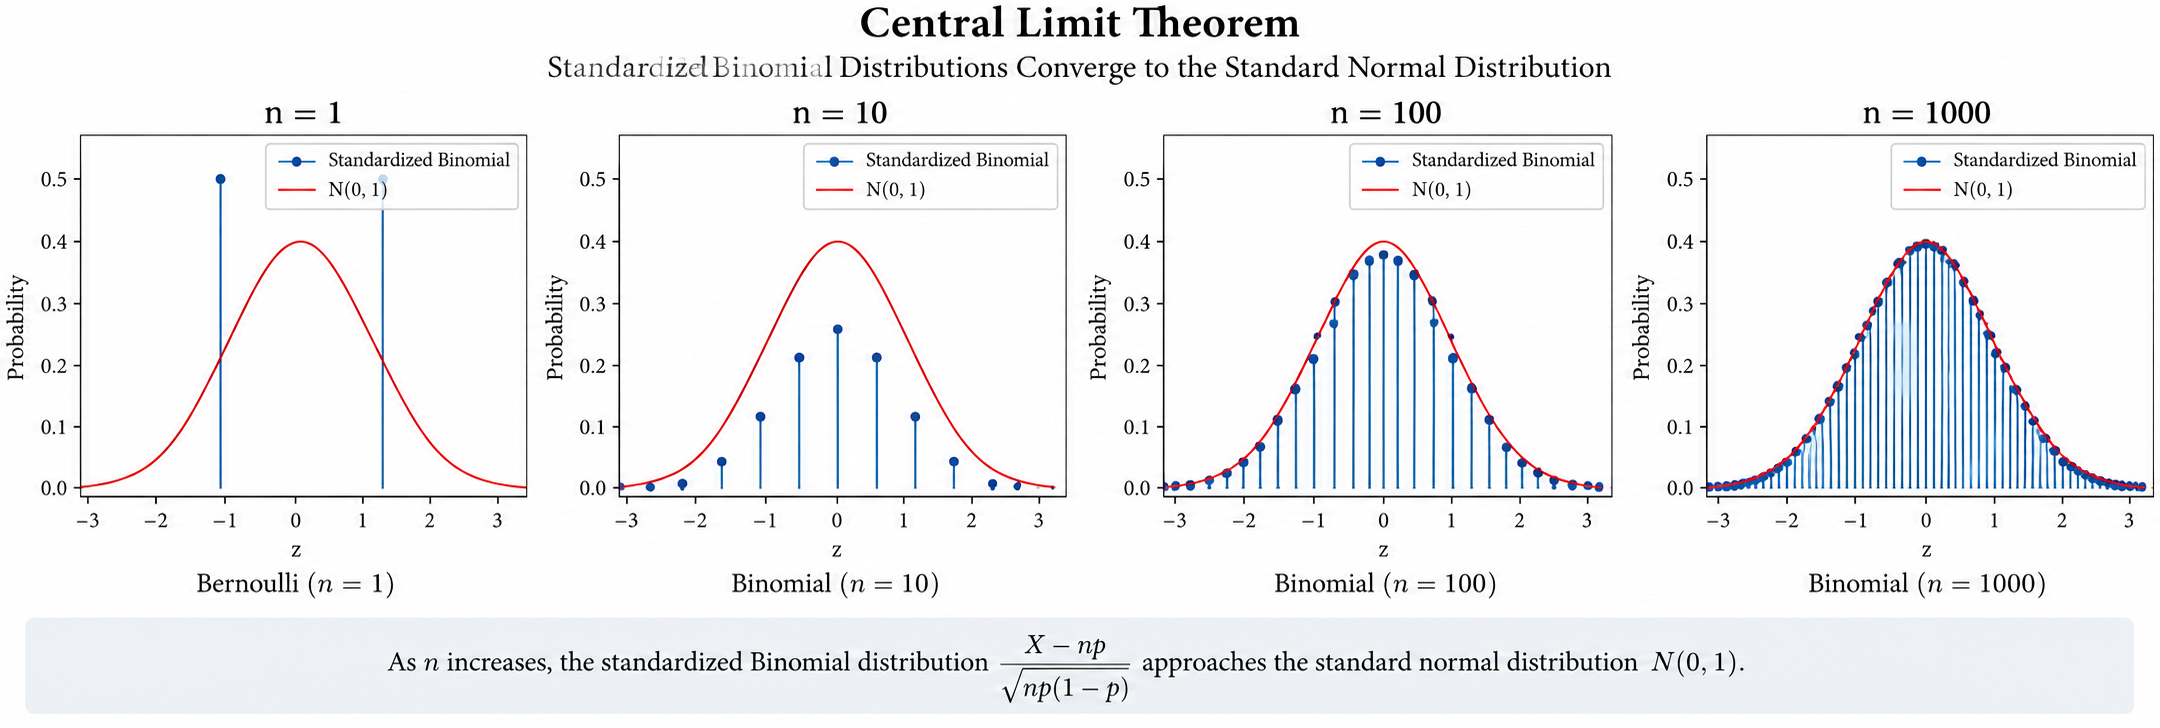
所以当 n 较大时,Binomial 分布在合适条件下可以用 Gaussian 近似。
1.7.2 Binomial 的正态近似
如果 $ X (n,p), $
那么 $ E[X] = np, $ $ (X) = np(1-p). $
当 n 足够大,并且分布不是极度偏斜时 $ X (np,; np(1-p)). $
标准化后:
\frac{X - np}{\sqrt{np(1-p)}} \approx \mathcal{N}(0,1).
例如:
X \sim \mathrm{Binomial}(n, 0.2).
随着 n 增大,它经过中心化和标准化后的概率质量越来越接近标准高斯钟形曲线。
需要强调,n 很大就一定是 Gaussian是过度简化的说法。
中心极限定理有条件;另外,对于 Binomial 正态近似,p 极端接近 0 或 1 时通常也需要更大的 n 才能得到较好的近似。
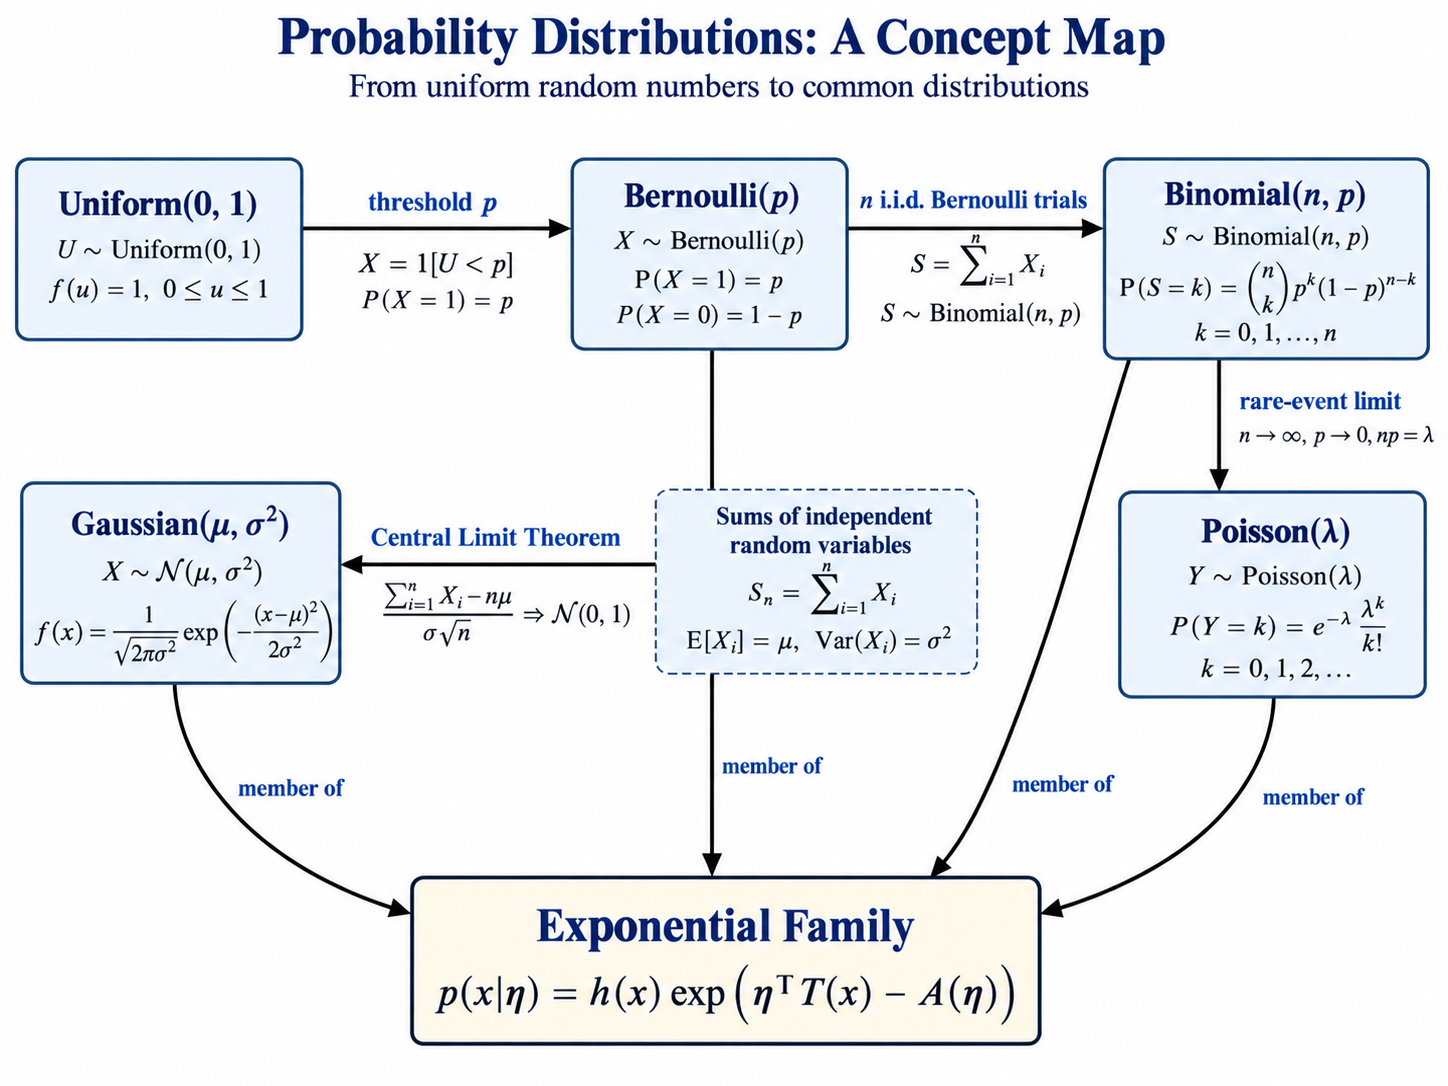
现在可以得到一张非常有用的关系图:
\mathrm{Bernoulli}(p)
重复 n 次并统计成功数:
\Downarrow
\mathrm{Binomial}(n,p).
当:
n \to \infty, \qquad p \to 0, \qquad np = \lambda
时:
\Downarrow
\mathrm{Poisson}(\lambda).
另一方面,对大量独立随机变量求和并进行中心化、标准化:
\Downarrow
在 CLT 条件下趋近:
\mathcal{N}(0,1).
于是同一个 Binomial 分布,在不同参数区域甚至可以出现两种不同的重要近似:
\boxed{
\mathrm{Binomial} \longrightarrow
\begin{cases}
\text{Poisson approximation}, & n \text{ 大、} p \text{ 小、} np \text{ 有限}, \\
\text{Normal approximation}, & n \text{ 大且分布不太偏斜}.
\end{cases}
}
两种近似并不矛盾,而是对应不同的渐近场景。
1.8 指数族 Exponential Family
前面介绍的分布看似各有各的公式,但它们中的很多都属于同一个巨大的分布家族,指数族分布。
指数族的一种标准形式为:
\boxed{p(x \mid \eta) = h(x) \exp\left(\eta^\top T(x) - A(\eta)\right)}
其中 $ h(x) $ 叫做基准测度 (base measure);
$ $ 叫做自然参数 (natural parameter),也叫 canonical parameter;
$ T(x) $ 叫做充分统计量 (sufficient statistic);
$ A() $ 叫做对数配分函数 (log-partition function)。
如何理解每个参数的具体含义呢?
h(x) x 有关,不依赖参数。
T(x)
\eta
A(\eta)
$ p(x ),dx = 1 $ 或离散情况 $ _x p(x ) = 1. $
因此它本质上承担归一化常数的角色。
指数族不是单纯为了把公式写得漂亮。它有几个很深的意义。首先,大量常见分布都属于指数族,例如:
\text{Bernoulli}, \quad \text{Binomial}, \quad \text{Poisson}, \quad \text{Gaussian},
以及很多其他分布。
其次,在适当正则条件下:
\boxed{E_\eta[T(X)] = \nabla_\eta A(\eta)}
而且:
\boxed{\mathrm{Cov}_\eta[T(X)] = \nabla_\eta^2 A(\eta)}.
所以 A(\eta) 不只是一个为了归一化而出现的函数,它还编码了分布的重要矩信息。
当充分统计量就是 X 时:
$ E[X] $ 以及相关的方差信息就可以直接从 A(\eta) 的导数中得到。
1.8.1 Gaussian 如何写成指数族?
这是一个非常值得手推一次的例子。
Gaussian 密度:
p(x \mid \mu, \sigma) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right).
先把平方项展开:
(x-\mu)^2 = x^2 - 2\mu x + \mu^2.
所以:
-\frac{(x-\mu)^2}{2\sigma^2} = -\frac{x^2}{2\sigma^2} + \frac{\mu x}{\sigma^2} - \frac{\mu^2}{2\sigma^2}.
于是:
p(x \mid \mu, \sigma) = \frac{1}{\sqrt{2\pi}} \exp\left[\frac{\mu}{\sigma^2}x - \frac{1}{2\sigma^2}x^2 - \frac{\mu^2}{2\sigma^2} - \log\sigma\right].
将它和:
p(x \mid \eta) = h(x) \exp\left(\eta^\top T(x) - A(\eta)\right)
进行比较。
充分统计量
可以选择:
\boxed{T(x) = \begin{bmatrix} x \\ x^2 \end{bmatrix}}.
这意味着 Gaussian 关于未知 \mu, \sigma^2 的参数信息可以通过:
x, \qquad x^2
来组织。
如果有一组独立样本:
x_1, \ldots, x_n,
那么联合分布最终只需要:
\sum_{i=1}^{n} x_i
和
\sum_{i=1}^{n} x_i^2
这两类统计量来承载相应参数信息。
自然参数
定义:
\boxed{\eta_1 = \frac{\mu}{\sigma^2}}
和:
\boxed{\eta_2 = -\frac{1}{2\sigma^2}}.
于是:
\eta = \begin{bmatrix} \dfrac{\mu}{\sigma^2} \\[2mm] -\dfrac{1}{2\sigma^2} \end{bmatrix}.
自然参数空间还必须满足:
\eta_2 < 0.
h(x)
一种常用分解方式为:
\boxed{h(x) = \frac{1}{\sqrt{2\pi}}}.
A(\eta)
根据:
\eta_1 = \frac{\mu}{\sigma^2}, \qquad \eta_2 = -\frac{1}{2\sigma^2},
有:
\sigma^2 = -\frac{1}{2\eta_2}.
同时:
\mu = -\frac{\eta_1}{2\eta_2}.
Gaussian 中剩下的参数项为:
\frac{\mu^2}{2\sigma^2} + \log\sigma.
因此:
\boxed{A(\eta) = -\frac{\eta_1^2}{4\eta_2} - \frac{1}{2}\log(-2\eta_2)}
其中:
\eta_2 < 0.
最终:
p(x \mid \eta) = \frac{1}{\sqrt{2\pi}} \exp\left[\eta_1 x + \eta_2 x^2 - A(\eta)\right].
这就是 Gaussian 的指数族表示。
从 Gaussian 的 A(\eta) 恢复期望
指数族有:
E[T(X)] = \nabla A(\eta).
因为:
T(X) = \begin{bmatrix} X \\ X^2 \end{bmatrix},
所以:
\frac{\partial A}{\partial \eta_1} = E[X].
由:
A(\eta) = -\frac{\eta_1^2}{4\eta_2} - \frac{1}{2}\log(-2\eta_2),
得到:
\frac{\partial A}{\partial \eta_1} = -\frac{\eta_1}{2\eta_2}.
而刚才已经有:
\mu = -\frac{\eta_1}{2\eta_2},
因此:
\boxed{E[X] = \mu}.
同理:
\frac{\partial A}{\partial \eta_2} = E[X^2].
进一步就可以通过:
\mathrm{Var}(X) = E[X^2] - E[X]^2
恢复:
\boxed{\mathrm{Var}(X) = \sigma^2}.
这说明指数族不是在”换一种方式抄 Gaussian 公式”,而是把一个分布中关于参数;统计量;均值;方差;归一化的关系全部统一了起来。
1.8.2 Bernoulli 其实也是指数族
为了进一步理解指数族,可以把最开始的 Bernoulli 再拿回来。
Bernoulli PMF:
p(x \mid p) = p^x (1-p)^{1-x}.
取对数:
\log p(x \mid p) = x \log p + (1-x)\log(1-p).
整理:
= x \log\frac{p}{1-p} + \log(1-p).
定义自然参数:
\eta = \log\frac{p}{1-p},
于是:
p = \frac{e^\eta}{1+e^\eta}.
这正是熟悉的 sigmoid:
p = \sigma(\eta).
又因为:
-\log(1-p) = \log(1+e^\eta),
所以:
p(x \mid \eta) = \exp\left[\eta x - \log(1+e^\eta)\right].
因此:
T(x) = x,
h(x) = 1,
\boxed{A(\eta) = \log(1+e^\eta)}.
而:
A'(\eta) = \frac{e^\eta}{1+e^\eta} = p.
所以:
E[X] = p.
二阶导:
A''(\eta) = p(1-p).
因此:
\mathrm{Var}(X) = p(1-p).
这把我们文章开头手算出的 Bernoulli 均值和方差重新推导了一遍。
更重要的是,它解释了为什么逻辑回归中会自然出现 sigmoid 和 log-odds :
\eta = \log\frac{p}{1-p}.
1.8.3 Poisson 同样属于指数族
Poisson:
p(x \mid \lambda) = \frac{\lambda^x e^{-\lambda}}{x!}.
改写:
p(x \mid \lambda) = \frac{1}{x!} \exp\left(x \log\lambda - \lambda\right).
令:
\eta = \log\lambda,
则:
\lambda = e^\eta.
于是:
p(x \mid \eta) = \underbrace{\frac{1}{x!}}_{h(x)} \exp\left[\underbrace{\eta}_{\text{natural parameter}} \underbrace{x}_{T(x)} - \underbrace{e^\eta}_{A(\eta)}\right].
所以:
\boxed{A(\eta) = e^\eta}.
马上得到:
E[X] = A'(\eta) = e^\eta = \lambda.
以及:
\mathrm{Var}(X) = A''(\eta) = e^\eta = \lambda.
这又重新得到了:
\boxed{E[X] = \mathrm{Var}(X) = \lambda}.
这也是理解指数族价值的一个非常漂亮的例子。