随机变量与概率分布基础
在概率论中,我们经常面对这样的情况,一个随机实验产生一个结果,但是我们真正关心的是结果对应的数值。
例如抛硬币这个行为,我们把正面记作1,反面记作0.那么实验结果可以通过一个函数映射成数字:
X=\begin{cases} 1, & \text{正面}\\ 0, & \text{反面} \end{cases}
这个 X 就叫做随机变量(Random Variable)。
需要注意的是,随机变量虽然叫变量,但是它本质上是一个函数:
X:\Omega \rightarrow R
它把随机事件映射到实数。
1.1 离散随机变量和连续随机变量
随机变量主要分两类:
1.1.1 离散随机变量(Discrete Random Variable)
如果随机变量的取值是有限或者可数无限的,例如:
X = 0, 1, 2, ...
那么称为离散随机变量。例如抛硬币次数,一天内顾客数量,骰子的点数
离散随机变量可以直接计算:
P(X=x)
如:
P(X=1) = 0.5
代表了随机变量取 1 的概率。
1.1.2 连续随机变量(Continuous Random Variable)
如果随机变量可以取某个区间内任意值,例如:
X \in (0, 1)
那么称为连续随机变量。例如身高,温度,时间,测量误差等等
连续随机变量最大的特点:单个点出现的概率为 0。即:
P(X=x) = 0
这是因为连续变量有无限多个可能值。故对于单个点赋予概念是没有意义的.
当然,不是说概率为0,这个事件就不可能存在.例如一个人的身高正正好的是170cm,他肯定是在身高的可能取值之间的,此时就证明了,概率为0不一定存在,概率为1也不一定发生.
Eg1:向飞镖靶扔飞镖,求恰好落在离靶心 2 cm 处概率
1° 以 1 cm 精度进行测量:0, 1, 2, 3 cm ……
假设扔了 100 枚,其中 20 枚落入 [1.5,2.5),P=20\%。
但仔细一看,并不满足我们的问题!测出的是区间概率,而不是精确点概率。
2° 把精度提升到 0.1 cm,区间变为 [1.95,2.05),P=3\%。
可以看出,2 比 1 的精度提升了,概率就会变小;显然我们并没有解决问题,只是把问题又往下推了一步。
让我们稍微抽象一些:
假设我们知道前k位数字已经匹配了,即距离中心为2.00…,精确到k位小数,现在想知道其匹配到前k+1位的概率.
可认为,第k+1位数字本质上从集合{0, 1, 2, …, 9}中随机挑选:
P(distance\ is\ 2.000..., to\ k\ digits) ≈ p·10^{-k}
显然,无论你的p怎么取,由于其是一个常数,当我们的k趋于无穷时,即无穷接近一个确切的数,如2. 此时的P应当是为0的
可以看出来,这种情况我们其实不应该关注某一个点的概率,而是一个区间的概率。
我们引入区间长度\epsilon,如k=4时,那就意味着,我们知道值应该落入区间[1.99995, 2.00005]。长度为1 × 10^{-4}
一个单独的点没有长度,因此连续概率不能通过单点概率来描述,而应该通过区间概率来描述。
这正是概率密度函数出现的原因。
1.2 概率密度函数
这个函数的作用是,描述概率在什么地方更集中。
设连续随机变量X的概率密度函数为:
p(x)
如果考虑 x 附近一个非常小的区间,例如长度为 \varepsilon,那么有近似关系:
\boxed{P(X \text{ 落在 } x \text{ 附近长度为 } \varepsilon \text{ 的区间}) \approx p(x)\varepsilon}
可以注意到,p(x)描述的是单位长度附近聚集了多少概率。因此它叫 Probability Density Function,概率密度函数。
其有以下三个必定满足的条件:
- p(x)≥0,即:
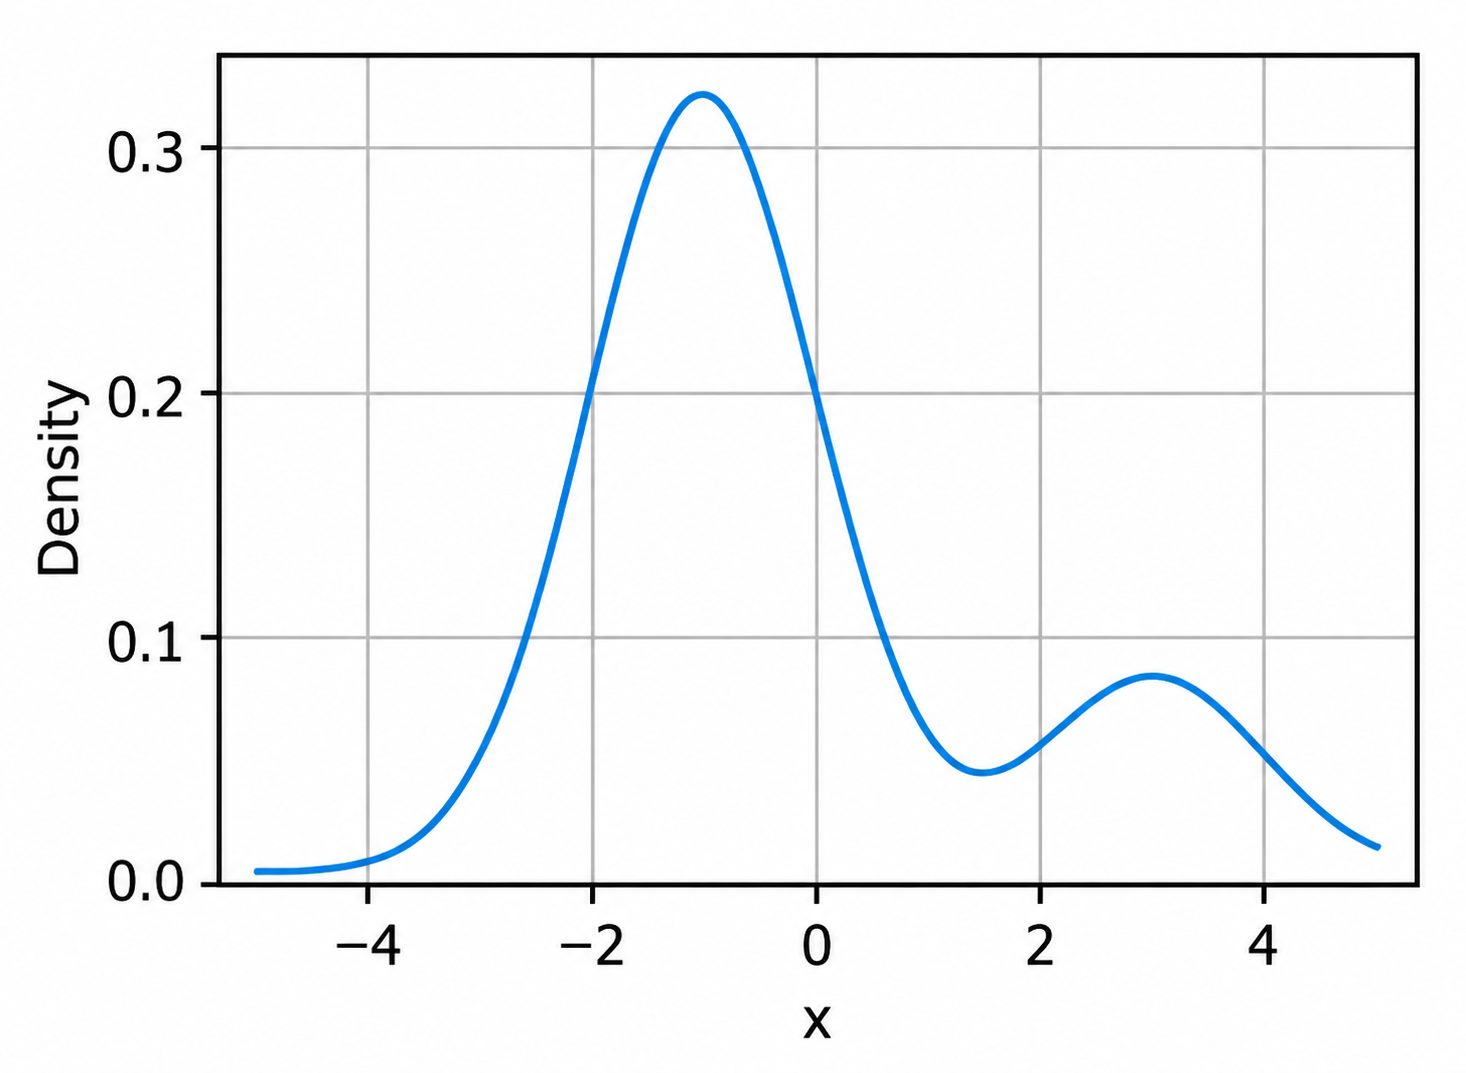
- 整个实数轴上的概率必须等于 1:
\int_{-\infty}^{+\infty} p(x)\,dx = 1
- 某个区间上的概率由面积给出:
P(a \leq X \leq b)=\int_{a}^{b} p(x)\,dx
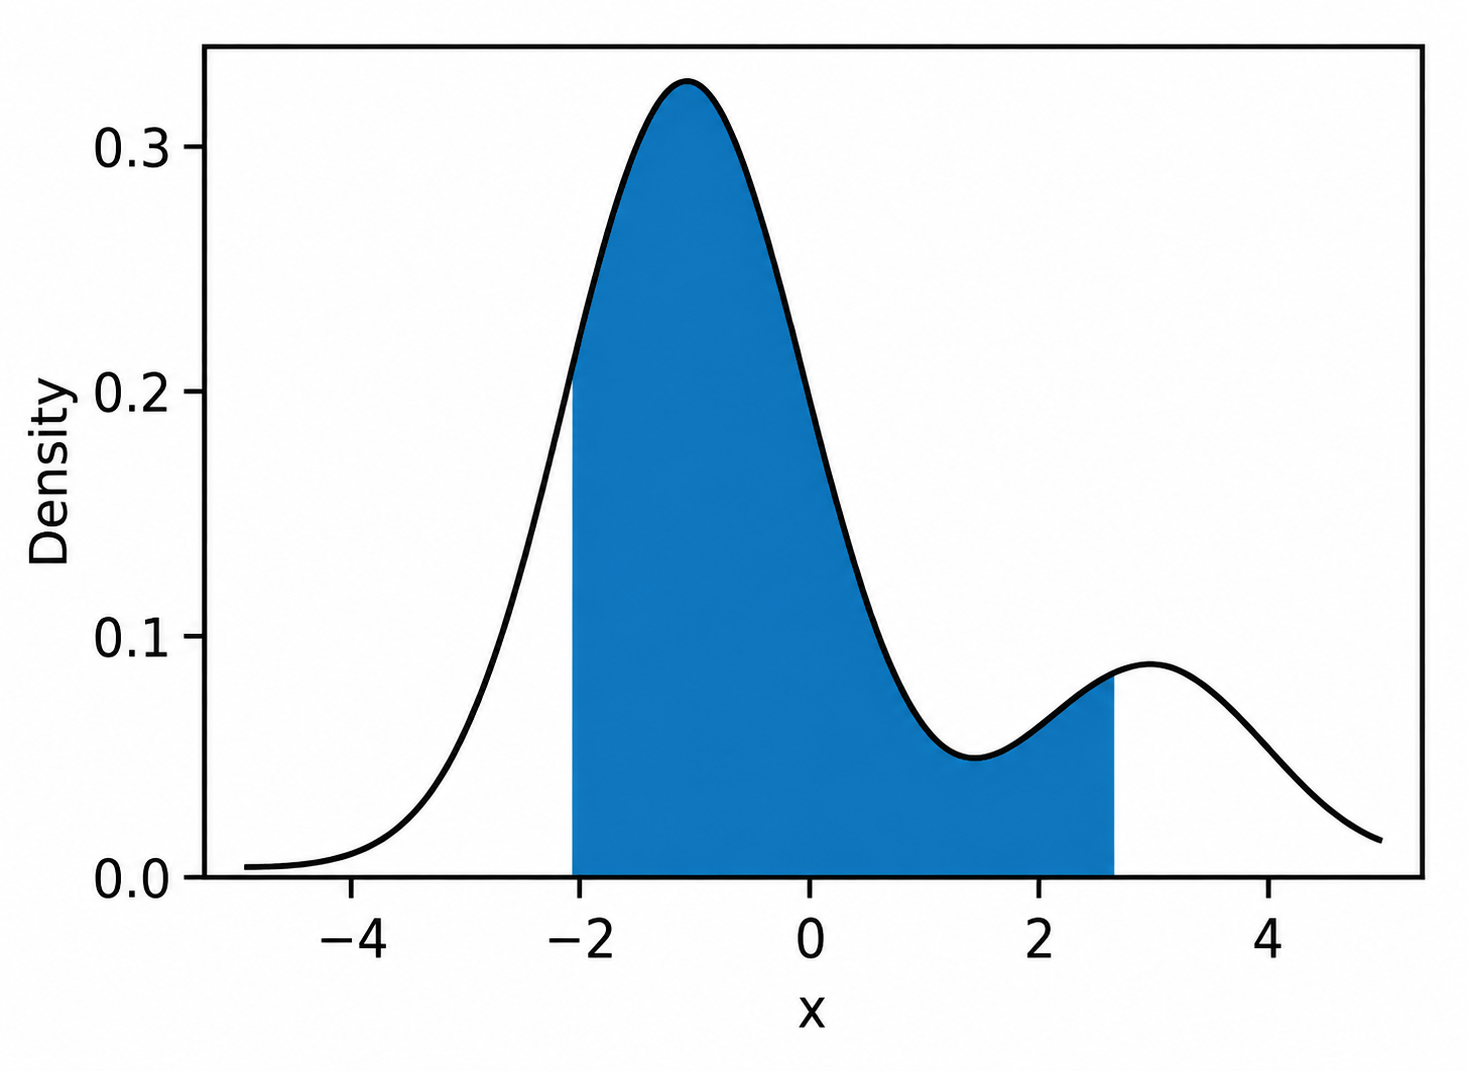
例如图中把某一区域涂成蓝色,那么那部分蓝色面积就是 X 落在相应区间中的概率。
这也解释了为什么“某一点上的概率密度很高”不能说成“这一点发生的概率很大”。密度不是概率
1.3 累积分布函数
PDF 描述“局部概率密度”,而另一个非常重要的对象叫做累积分布函数:Cumulative Distribution Function(CDF)
\boxed{F(x)=P(X \leq x)}.
如果 X 具有密度 p(x),那么
\boxed{F(x)=\int_{-\infty}^{x} p(t)\,dt}.
这里积分变量写成 t 会更清楚,因为 x 是积分上限。
直观上,CDF 做的事情就是:从最左边开始,把 PDF 曲线下面积一路累加到 x。
因此它天然表示一个真实概率。
根据上面的关系,我们可以得到:
p(x)=F^{\prime}(x)
所以可以这样理解: \text{PDF 是局部密度,CDF 是累计概率}
一个是变化率,一个是累积量。
这和速度、位移之间的关系非常相似。
CDF有以下几点特点:
F(x) \to 0, x \to -\infty
F(x) \to 1, x \to +\infty
如果y > x, 那么事件X \leq x一定包含在X \leq y之中,因此:
F(y) \geq F(x)
- 所以 CDF 必然单调不减。对于具有概率密度的连续随机变量,CDF 是一条连续的曲线。
注意,CDF对于离散随机变量同样适用,例如假设P(X=0)=P(X=1)=0.5,那么其CDF应为:
F(x)= \begin{cases} 0, & x<0, \\[4pt] \dfrac{1}{2}, & 0 \leq x<1, \\[4pt] 1, & x \geq 1. \end{cases}
此时的CDF就是阶梯状的函数,所以 CDF 比 PDF 更通用,连续分布能用,离散分布能用,甚至离散和连续混合的分布也可以用。
1.4 均值
理解了分布之后,下一个自然的问题是,我能不能用一个数大致描述这个随机变量通常处在哪里?这就是期望,也就是均值。
对于离散随机变量,假设P(X = x_i)=p_i,那么:
\boxed{\mu_{X}=E[X]=\sum_{i} x_{i} p_{i}}.
其本质上就是一个加权平均,不同结果的权重就是它们发生的概率。
对于连续随机变量,其均值为:
\boxed{\mu_{X}=E[X]=\int_{-\infty}^{+\infty} x\,p(x)\,dx}.
可以把离散情形中的求和 $ $ 理解为在连续情况下变成了积分 $ . $
如果Y=aX+b,那么变量Y的均值应当为:
E(Y) = aE(X)+b
且无论X,Y是否独立,都有:
E(X+Y) = E(X)+E(Y)
期望的这个线性性质非常强,因为它不要求独立性。
考虑两个随机变量。它们的均值可能完全一样,但一个数据都集中在均值附近,另一个数据可能分散得很开。所以只知道均值是不够的。
我们还需要衡量数值到底偏离中心多少。概率论和统计学中最常用的是平方偏差,由此得到方差。(当然也存在绝对方差,这一点读者可以自行探索)
1.5 方差
根据我们上面分析的,方差就是用来表述数据的分散情况。定义为:
\boxed{\operatorname{Var}(X)=E\left[\left(X-\mu_{X}\right)^{2}\right]}.
经常记作\sigma_{X}^{2}.
展开以后可以得到一个非常常用的公式: \operatorname{Var}(X)=E\left[X^{2}\right]-E[X]^{2}
证明很简单:
E\left[(X-\mu)^{2}\right]=E\left[X^{2}-2 \mu X+\mu^{2}\right].
利用期望线性性,上式等于E\left[X^{2}\right]-2 \mu E[X]+\mu^{2}.。又因为E[X]=\mu,于是:
\operatorname{Var}(X)=E\left[X^{2}\right]-\mu^{2}.
\operatorname{Var}(X) \geq 0.,因为平方永远非负。当\operatorname{Var}(X)=0,那么随机变量实际上没有波动,也就是处处为一个常数。
如果进行线性变换Y=a X+b,,那么\operatorname{Var}(Y)=a^{2} \operatorname{Var}(X),这里特别值得注意的是平移的b并不影响方差,因为整体往左或者往右移动,并不会改变数据自身的离散程度。
如果 X, Y 相互独立,那么\operatorname{Var}(X+Y)=\operatorname{Var}(X)+\operatorname{Var}(Y)
后面会看到,这其实是更一般公式:\operatorname{Var}(X+Y)=\operatorname{Var}(X)+\operatorname{Var}(Y)+2 \operatorname{Cov}(X, Y)在独立情况下的特殊形式。
因为独立意味着\operatorname{Cov}(X, Y)=0.
1.5.1 标准差
方差有一个不太方便的地方如果 X的单位是米,那么方差的单位是米^2,不太直观,因此定义标准差:
\boxed{\sigma_{X}=\sqrt{\operatorname{Var}(X)}}.
这样标准差和原来的随机变量具有相同单位。
因此通常可以把均值理解成中心,而把标准差或方差理解成波动、风险或离散程度,这也是金融和机器学习中非常常见的直觉。
标准差满足 $ _{X} $ 以及:
\sigma_{a X+b}=|a| \sigma_{X}
如果 X, Y 独立:
\sigma_{X+Y}=\sqrt{\operatorname{Var}(X)+\operatorname{Var}(Y)}
1.6 切比雪夫不等式
即使我们完全不知道一个随机变量到底服从什么分布,只要均值和方差存在,就有切比雪夫不等式: P\left(\left|X-\mu_{X}\right| \geq d \sigma_{X}\right) \leq \frac{1}{d^{2}}
其中d>0.等价地: P\left(\mu_{X}-d \sigma_{X}<X<\mu_{X}+d \sigma_{X}\right) \geq 1-\frac{1}{d^{2}}
例如取d=2,得到:
P\left(\left|X-\mu_{X}\right| \geq 2 \sigma_{X}\right) \leq \frac{1}{4}.
也就是说:
P\left(\left|X-\mu_{X}\right|<2 \sigma_{X}\right) \geq \frac{3}{4}
所以不论分布长什么样,只要方差有限,至少有 75% 的概率落在均值左右两个标准差的范围内。
连续随机变量的均值和方差:
对于连续随机变量, \boxed{\mu_{X}=\int_{-\infty}^{+\infty} x\,p(x)\,dx}.
二阶矩为 E\left[X^{2}\right]=\int_{-\infty}^{+\infty} x^{2} p(x)\,dx.
因此 \boxed{\operatorname{Var}(X)=\int_{-\infty}^{+\infty} x^{2} p(x)\,dx-\left(\int_{-\infty}^{+\infty} x\,p(x)\,dx\right)^{2}}.
Eg1:对于一种均匀分布的情况;
假设: p(x)= \begin{cases} 1, & x \in[0,1], \\ 0, & \text { 其他. } \end{cases}
那么 E[X]=\int_{0}^{1} x\,dx=\frac{1}{2}.
同时 E\left[X^{2}\right]=\int_{0}^{1} x^{2}\,dx=\frac{1}{3}.
所以 \operatorname{Var}(X)=\frac{1}{3}-\left(\frac{1}{2}\right)^{2}=\boxed{\frac{1}{12}}.
Eg2:柯西分布的情况,不是所有随机变量都有均值和方差:
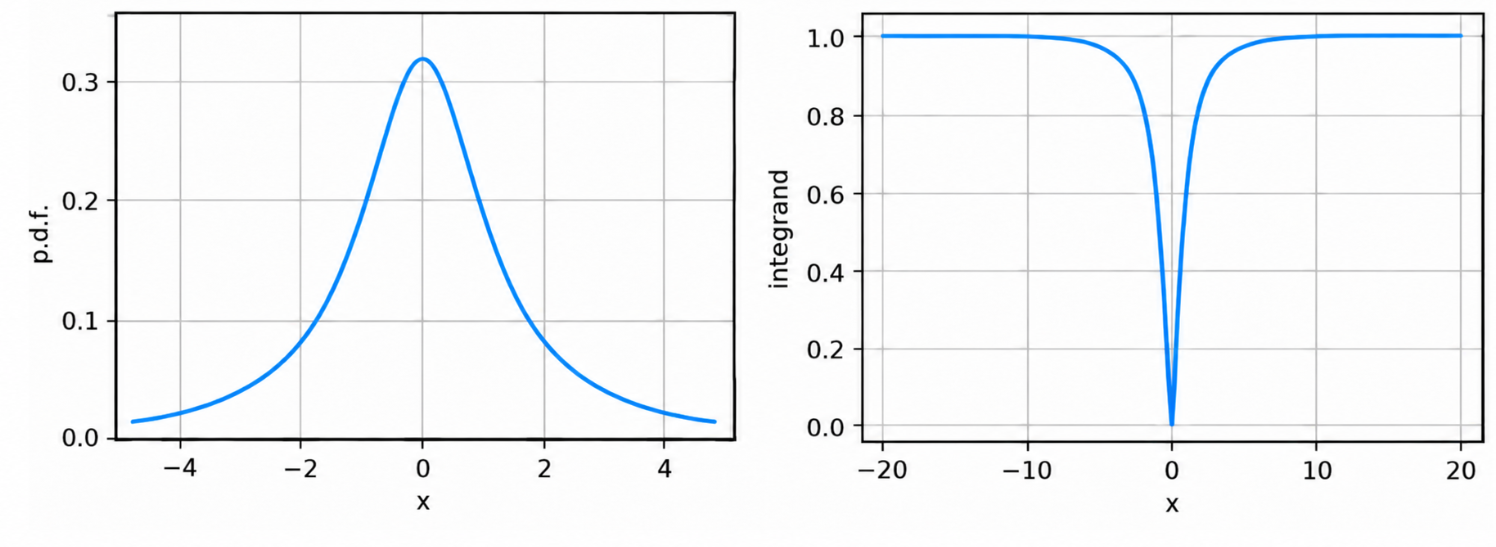
此图的左图是柯西分布的概率密度函数,其为:
p(x)=\frac{1}{\pi\left(1+x^{2}\right)}
根据公式,我们会尝试计算均值:
E[X]=\int_{-\infty}^{+\infty} x\,\frac{1}{\pi\left(1+x^{2}\right)}\,dx.
虽然函数关于 0 是奇函数,而且用“对称主值”的方式可能会得到 0,但这并不代表期望存在。
我们可以设u = x^2+1,则原式变成了:
E[X]=\int_{1}^{+\infty} \frac{1}{2} \frac{1}{\pi u} du.
E[X]=\frac{1}{2} \ln(+\infty)
故是不存在的。是发散的
类似的:
E\left[X^{2}\right]=\int_{-\infty}^{+\infty} \frac{x^{2}}{\pi\left(1+x^{2}\right)}\,dx
也发散。
这个例子提醒我们,并不是所有随机变量都适合用均值和方差描述
1.7 联合概率密度
前面只研究了一个随机变量 X。现实问题中,我们通常同时面对多个随机变量。
例如机器学习中的一张图像,可以把不同位置上的像素记成R_{ij},不同像素一般并不是互不相关的。
一个位置的像素很亮,往往意味着附近像素也更可能具有某些相似特征。因此我们必须研究(X,Y),甚至(X_1, X_2,...,X_n)的联合分布。
二维连续随机变量 (X,Y) 的联合概率密度记作:
p_{X,Y}(x, y)
考虑点 (x,y) 附近边长为 \varepsilon 的小正方形。根据我们前面一维连续随机变量的经验:
P(X在x附近,Y在y附近)≈p(x, y)\varepsilon^2
联合概率密度也同样有一些特性,如下:
p(x, y) \geq 0
整个平面的总概率是\int_{\mathbb{R}^{2}} p(x, y)\,dx\,dy=1
如果 D 是平面上的某个区域,那么P((X, Y) \in D)=\iint_{D} p(x, y)\,dx\,dy
所以一维中的曲线下面积,到了二维中就变成了曲面下面的体积。
如果 X, Y 独立,那么p_{X, Y}(x, y)=p_{X}(x)\,p_{Y}(y)
这就是连续随机变量独立性的一个核心表达。但现实数据中,大量变量并不独立。特别是在机器学习中,相邻像素、时间序列相邻时刻、相邻空间位置通常都有依赖关系。
因此不能随意假设p(x, y)=p(x)\,p(y).
1.8 边缘分布
假设已经知道p_{X, Y}(x, y).
现在只想知道 X 的分布怎么办?把所有可能的 y 都加起来即可。
连续情况下就是积分:
p_{X}(x)=\int_{-\infty}^{+\infty} p_{X, Y}(x, y)\,dy
同理:
p_{Y}(y)=\int_{-\infty}^{+\infty} p_{X, Y}(x, y)\,dx
这叫做边缘化 marginalization。
直观地看,就是把二维概率质量沿某一个方向全部累积起来,最后投影成一个一维分布。
这个思想可以直接推广到高维。
例如已经知道p(x, y, z),
想求 X, Y 的联合分布:
p_{X, Y}(x, y)=\int_{-\infty}^{+\infty} p(x, y, z)\,dz.
边缘化是概率图模型、贝叶斯推断和机器学习中极其基础的操作。
1.9 协方差
有了联合分布之后,我们可以进一步问,当 X 变大时,Y 是倾向于一起变大,还是倾向于变小,这就引出了协方差。
\boxed{\operatorname{Cov}(X, Y)=E\left[\left(X-\mu_{X}\right)\left(Y-\mu_{Y}\right)\right]}.
它也可以写成:
\boxed{\operatorname{Cov}(X, Y)=E[X Y]-E[X]\,E[Y]}.
离散随机变量的协方差
如果P\left(X=x_{i}, Y=y_{j}\right)=p_{ij},
那么 \boxed{\operatorname{Cov}(X, Y)=\sum_{i, j}\left(x_{i}-\mu_{X}\right)\left(y_{j}-\mu_{Y}\right) p_{ij}}.
如果 X 和 Y 经常一起高于各自均值或者一起低于均值,那么\left(X-\mu_{X}\right)\left(Y-\mu_{Y}\right) 通常为正,因此\operatorname{Cov}(X, Y)>0.
这就是正相关趋势。
反之,如果 X 高的时候 Y 往往低,那么乘积经常为负,因此\operatorname{Cov}(X, Y)<0.
此处我们举一个例子,设:
P Y=-1 Y=3 X=1 P/2 (1-P)/2 X=3 (1-P)/2 P/2 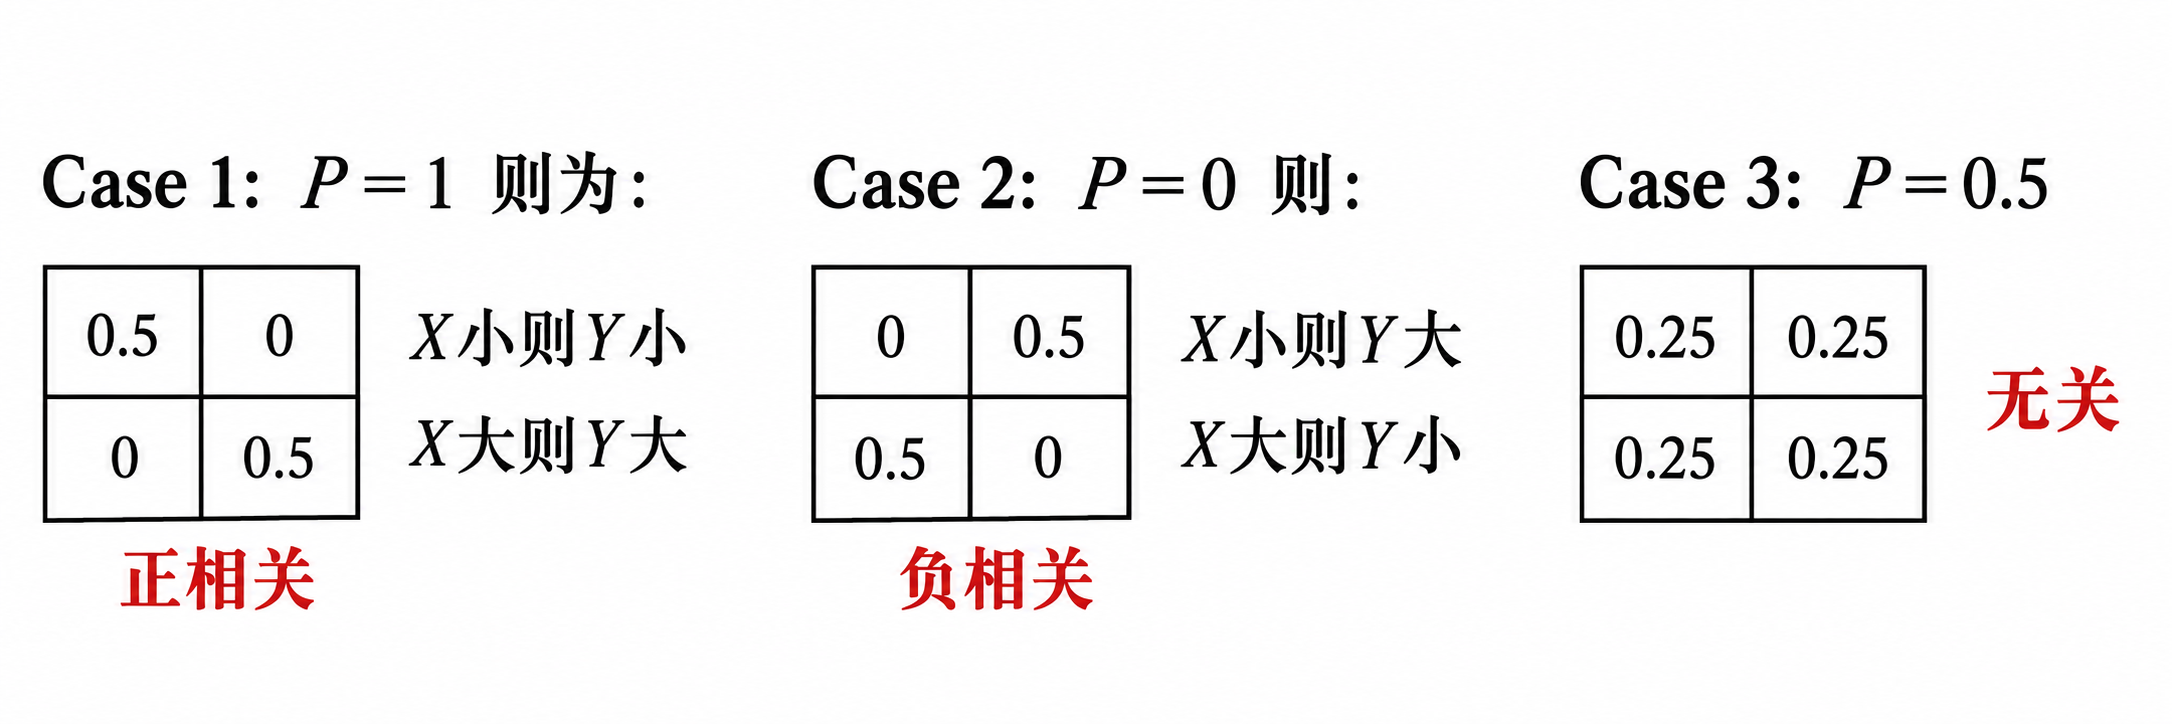
概率质量主要集中在对角线附近时表现为正协方差;集中在反对角线附近时表现为负协方差;四个格子均匀分布时,可以得到协方差为 0。
连续随机变量的协方差
对于连续变量, \boxed{\operatorname{Cov}(X, Y)=\iint\left(x-\mu_{X}\right)\left(y-\mu_{Y}\right) p_{X, Y}(x, y)\,dx\,dy}.
本质没有任何变化,只不过把离散求和改成了积分。
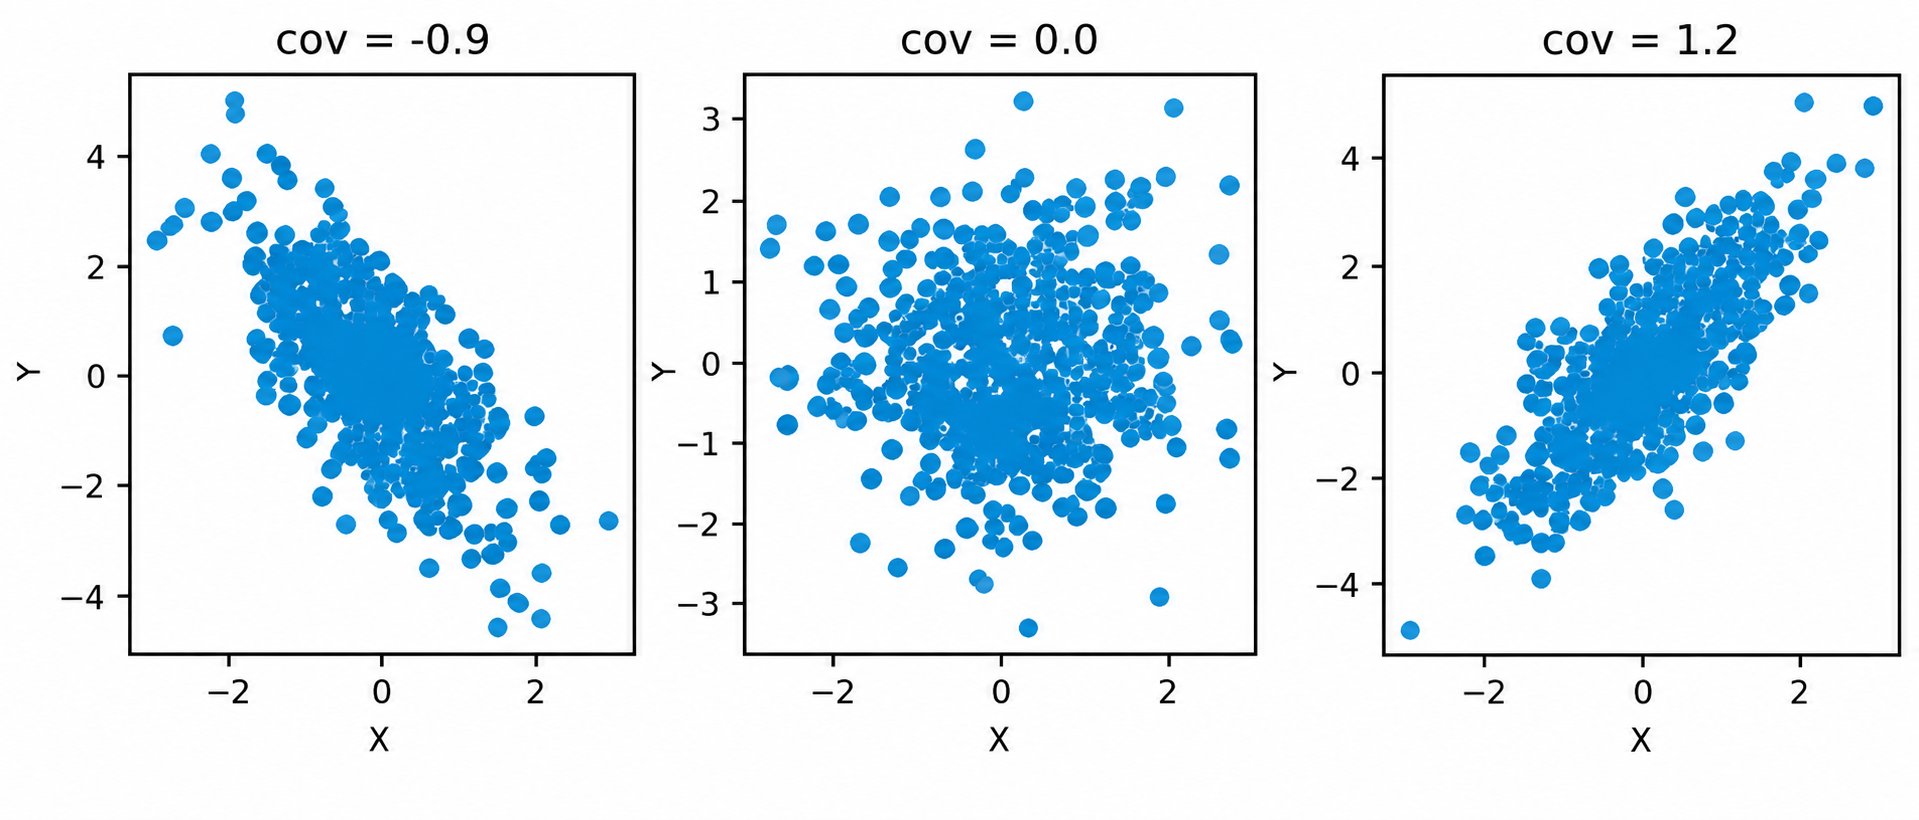
1.9.1 重要特性
- \operatorname{Cov}(X, X)=\operatorname{Var}(X)
所以方差其实就是随机变量和自身的协方差。
如果X \rightarrow a X+b,那么:
\operatorname{Cov}(a X+b, Y)=a \operatorname{Cov}(X, Y)
另外,如果 X, Y 独立,那么E[X Y]=E[X]\,E[Y],所以:
X, Y \text { 独立 } \quad \Rightarrow \quad \operatorname{Cov}(X, Y)=0
但是反过来不成立:
\operatorname{Cov}(X, Y)=0 \Rightarrow 无法得到 X, Y \text { 独立 }
这点尤其重要。协方差为 0只说明没有检测到线性共同变化,并不能保证两个变量之间不存在其他依赖关系。
现在就能解释之前的公式了。一般情况下,
\boxed{\operatorname{Var}(X+Y)=\operatorname{Var}(X)+\operatorname{Var}(Y)+2 \operatorname{Cov}(X, Y)}.
因此如果两个变量具有正协方差,它们叠加以后整体波动会更大。如果具有负协方差,二者会在一定程度上相互抵消。
而在独立情况下\operatorname{Cov}(X, Y)=0,所以才变成:
\operatorname{Var}(X+Y)=\operatorname{Var}(X)+\operatorname{Var}(Y).
但是还存在一个问题,就是单位的问题。例如把 X 从米改成厘米,相当于乘以 100。那么:
\operatorname{Cov}(100 X, Y)=100 \operatorname{Cov}(X, Y).
可是两个变量之间的实际关联强弱显然没有改变。所以单独比较协方差大小并不合理。
于是我们希望把协方差进行归一化。这就是相关系数。
1.10 相关系数
定义:
\rho(X, Y)=\frac{\operatorname{Cov}(X, Y)}{\sigma_{X} \sigma_{Y}}
在两个标准差都有限且非零时,有-1 \leq \rho(X, Y) \leq 1
因此相关系数最大的好处就是无量纲,而且不同问题之间可以直接比较。
通常\rho>0表示正的线性关联;\rho<0表示负的线性关联;\rho \approx 0表示几乎没有线性关联。
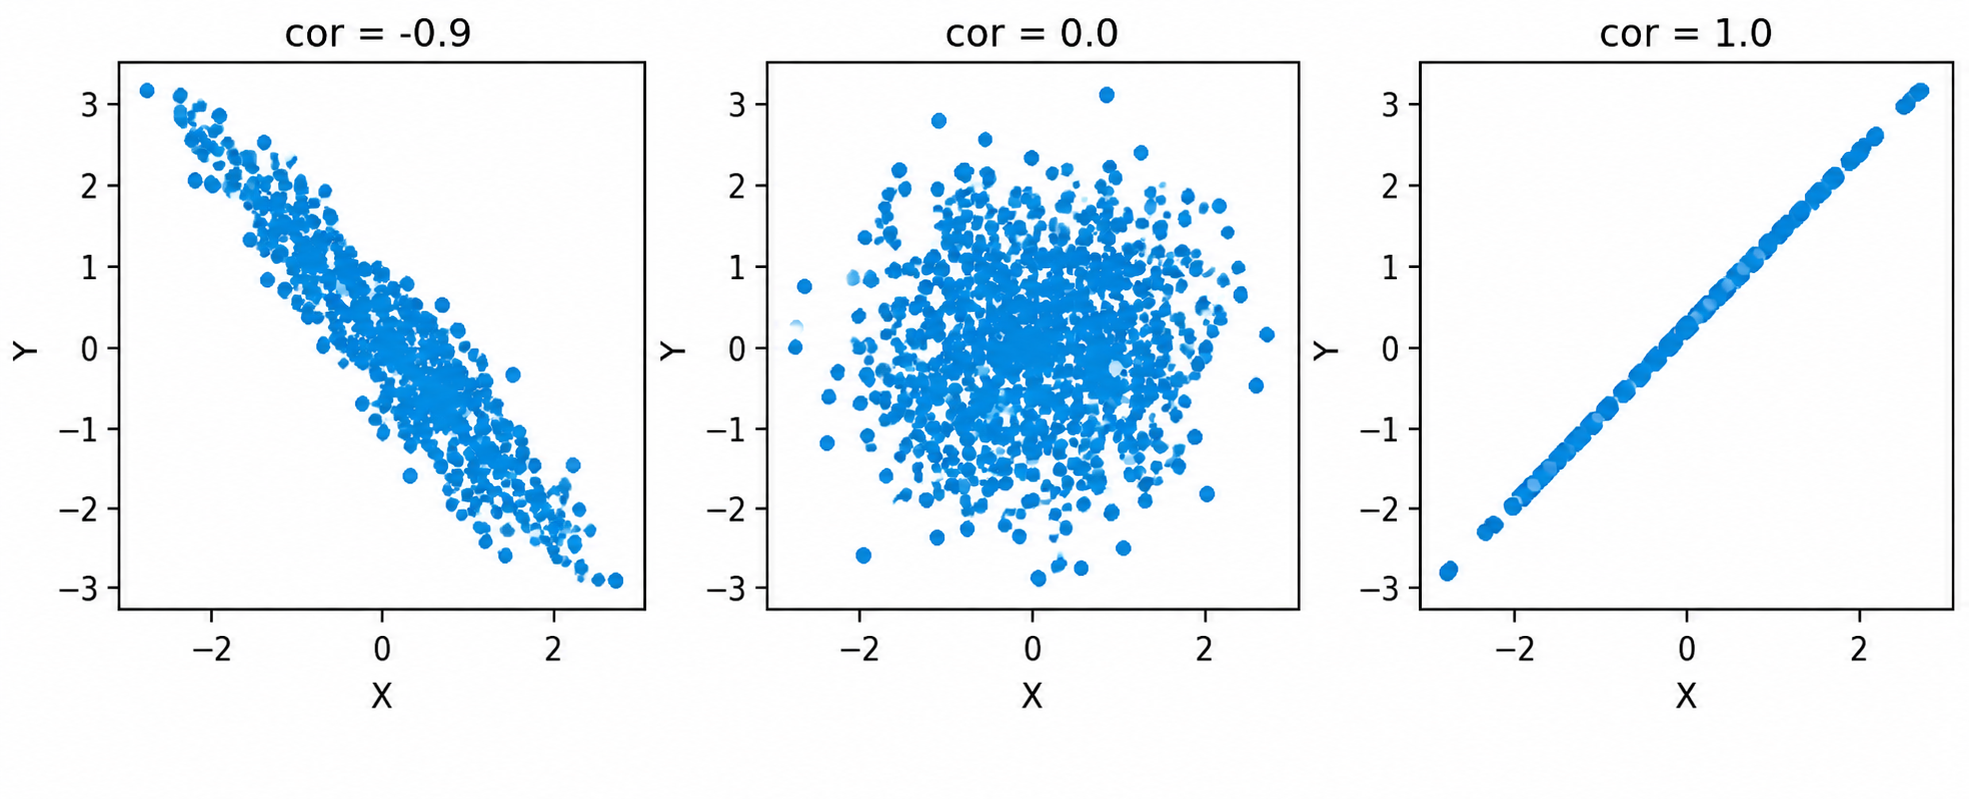
注意最后一句里的线性二字非常重要。
假设Y=a X+b,并且 X 不是常数。则\operatorname{Cov}(X, Y)=\operatorname{Cov}(X, a X+b)=a \operatorname{Var}(X).
同时\sigma_{Y}=|a| \sigma_{X}.
所以
\rho(X, Y)=\frac{a \operatorname{Var}(X)}{\sigma_{X}|a| \sigma_{X}}=\frac{a}{|a|}.
因此
\boxed{\rho(X, Y)= \begin{cases} 1, & a>0, \\ -1, & a<0 . \end{cases}}
也就是说,完全线性正关系对应 +1,完全线性负关系对应 -1。这里也顺便校正一个容易写错的公式。
对于a \neq 0,严格来说:
\rho(a X+b, Y)=\operatorname{sgn}(a)\,\rho(X, Y)
而不是对所有 a 都保持完全不变。
如果 X, Y 独立,并且相关系数有定义,那么
X, Y \text { 独立 } \Rightarrow \rho(X, Y)=0
但反过来仍然不成立:
\rho(X, Y)=0 \Rightarrow 不能证明 X, Y \text { 独立 }
原因就在于 Pearson 相关系数主要捕捉的是线性关系。
例如一个变量可能满足Y=X^{2},这显然是非常强的确定关系。
可是如果 X 关于 0 对称,则完全可能出现\operatorname{Cov}(X, Y)=\operatorname{Cov}\left(X, X^{2}\right)=0。此时两者显然不独立,却可能具有零 Pearson 相关系数。
假设\mu_{X}=\mu_{Y}=0 .
那么:
\rho(X, Y)=\frac{E[X Y]}{\sqrt{E\left[X^{2}\right] E\left[Y^{2}\right]}}
对于离散联合分布,它可以写成类似
\rho=\frac{\sum_{i, j} x_{i} y_{j} p_{i j}}{\sqrt{\left(\sum_{i, j} x_{i}^{2} p_{i j}\right)\left(\sum_{i, j} y_{j}^{2} p_{i j}\right)}} .
它的结构和线性代数中的余弦相似度:
\cos \theta=\frac{\mathbf{v}^{\top} \mathbf{w}}{\|\mathbf{v}\|\|\mathbf{w}\|}
非常相似。
所以可以把 Pearson 相关系数理解成:
在概率加权意义下,两个中心化随机变量之间的夹角相似度。
这也帮助我们理解为什么$-1 .而当=$时,意味着两个变量在这种意义下完全共线。
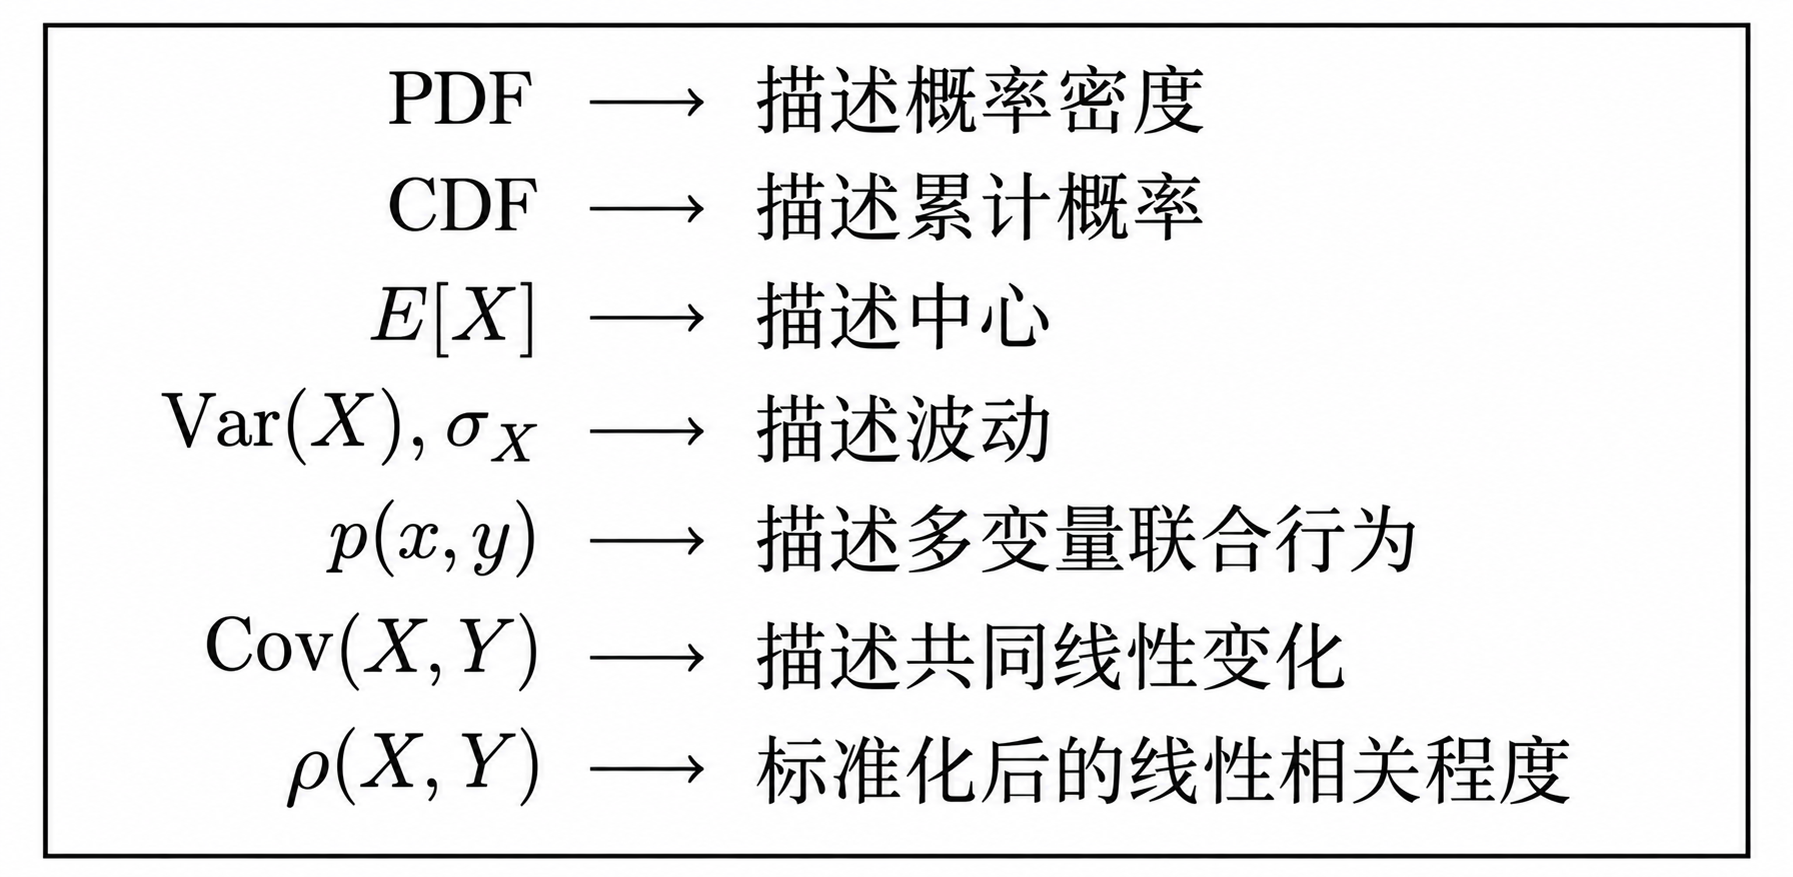
我们对这章做个总结,简单来说,各个变量的作用就是如下图所示: